Hướng Dẫn ElevenLabs: Đọc Lời Bình, Hiệu Ứng Âm Thanh, Dubbing Và Voice Agent
Hướng dẫn thực hành ElevenLabs qua sáu tác vụ thực tế, từ đọc lời bình cho video đến voice agent lễ tân, kèm ảnh chụp dashboard, chi phí credit và giới hạn của gói miễn phí.
ElevenLabs là nền tảng giọng nói AI. Nó biến văn bản thành giọng đọc, biến âm thanh thành văn bản, và biến một câu mô tả thành hiệu ứng âm thanh, bản nhạc hoặc một giọng hoàn toàn mới. Bài này chỉ cách dùng từng phần trong dashboard hiện tại, gói miễn phí với 10.000 credit làm được những gì và giới hạn nằm ở đâu.
Tôi đã chạy thật các luồng text-to-speech, hiệu ứng âm thanh và thiết kế giọng trên tài khoản miễn phí. Với dubbing, chuyển giọng nói thành văn bản, nhạc và agent, tôi dừng ở bước ngay trước khi tốn credit. Toàn bộ ảnh chụp lấy từ dashboard ngày 2026-10-21, và mỗi phần đều ghi rõ chỗ tôi dừng lại.
Thanh sidebar của dashboard liệt kê Voices, Studio, Flows, Chat và Assets, bên dưới là các công cụ được ghim (Text to Speech, Voice Creation, Sound Effects, Music, Speech to Text) và menu More tools. Agents nằm ở một nền tảng riêng, mở bằng nút chuyển nền tảng. Bảng sau nối mục tiêu với phần cần đọc:
| Bạn muốn | Đọc phần |
|---|---|
| Đọc to một kịch bản | Chuyển văn bản thành giọng đọc |
| Có bản transcript hoặc phụ đề | Chuyển âm thanh hoặc video thành văn bản |
| Đọc kịch bản dài hoặc dựng video | Đọc kịch bản dài hoặc dựng video (Studio) |
| Thêm âm thanh ngắn dưới clip | Tạo hiệu ứng âm thanh |
| Thêm nhạc cho đoạn mở đầu | Tạo nhạc nền |
| Có một giọng người dẫn nhất quán | Tạo hoặc nhân bản giọng riêng |
| Đăng video bằng ngôn ngữ thứ hai | Lồng tiếng video |
| Trả lời cuộc gọi và tin nhắn | Làm voice agent |
| Biết giá và giấy phép trước | Gói miễn phí, bảng giá và chọn model; Dùng thương mại |
Nếu bạn đã dùng AI trong công việc hằng ngày, hướng dẫn quy trình làm việc với agentic AI cho biết nên đặt lớp giọng nói ở đâu cạnh chat và trợ lý lập trình.
Gói miễn phí, bảng giá và chọn model nào
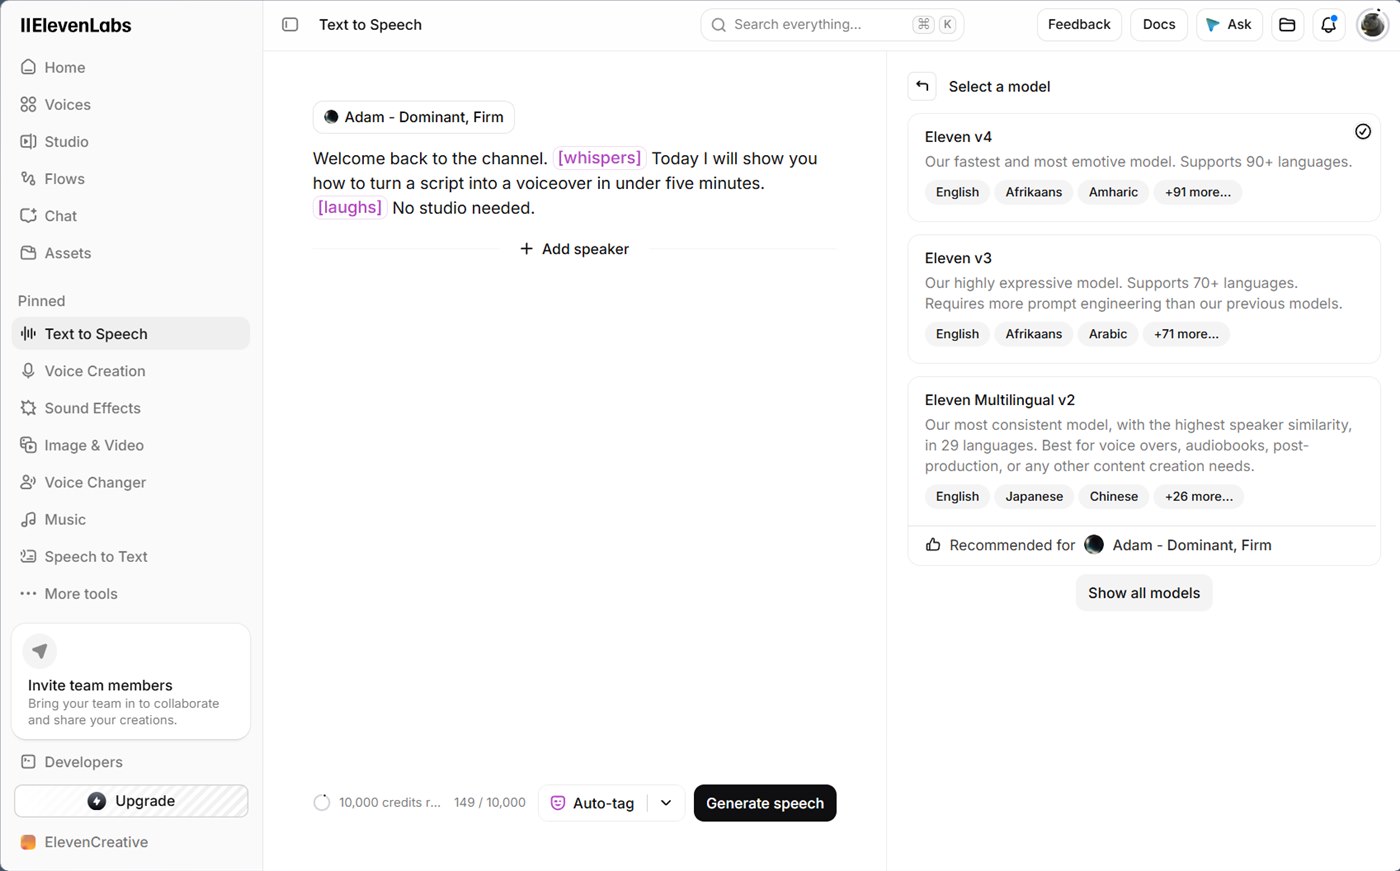
Tài liệu quảng bá dành cho đối tác của ElevenLabs vẫn gọi Eleven v3 là model chủ lực, hỗ trợ hơn 70 ngôn ngữ. Dashboard hiện nay đã khác. Ngày 2026-10-21, trang Text to Speech mặc định chọn Eleven v4. Bộ chọn model mô tả nó là "our fastest and most emotive model" và hỗ trợ hơn 90 ngôn ngữ. ElevenLabs công bố v4 ngày 28/09/2026, v3 vẫn chọn được, giờ là thế hệ trước.
| Model | Ngôn ngữ | Ký tự mỗi lần tạo | Audio tag | Dùng cho |
|---|---|---|---|---|
| Eleven v4 | 90+ | 10.000 | Có | Mặc định cho lời bình giàu cảm xúc |
| Eleven v3 | 70+ | 5.000 | Có | Dự án cũ cần dựng lại đúng như trước |
| Multilingual v2 | 29 | 10.000 | Không | Đọc dài, ổn định ở các ngôn ngữ được hỗ trợ |
| Flash v2.5 | 32 | 40.000 | Không | Tạo nhanh, rẻ hơn |
Mỗi model hỗ trợ một số ngôn ngữ khác nhau, nên hãy kiểm tra ngôn ngữ của bạn trước khi chọn. Ví dụ, tiếng Việt có trong v4, v3 và Flash v2.5 nhưng không có trong Multilingual v2, nên model đó là lựa chọn sai cho kịch bản tiếng Việt.
Gói miễn phí có 10.000 credit. Bảng giá trên trang pricing như sau:
| Gói | Giá mỗi tháng | Credit |
|---|---|---|
| Free | $0 | 10.000 |
| Starter | $6 | 30.000 |
| Creator | $22 | 121.000 |
| Pro | $99 | 600.000 |
Mức credit tôi thấy trong dashboard khi làm các tác vụ bên dưới:
- Tạo một hiệu ứng âm thanh: 200 credit (thời lượng tự động)
- Nhạc: 1.800 credit cho hai bản nhạc dài một phút
- Voice Design: giá hiện ngay trên nút Generate, 171 credit ở lần đầu tôi nhìn
- Dubbing, theo trang pricing: 2.000 credit cho mỗi phút nguồn ở mỗi ngôn ngữ đích khi có watermark, 3.000 khi không có
10.000 credit tương đương năm phút dubbing có watermark, nên hãy chọn kỹ thử nghiệm nào đáng làm trước khi tiêu.
Chuyển văn bản thành giọng đọc (Text to Speech)
Mục tiêu: biến kịch bản viết sẵn thành lời bình cho video hướng dẫn hoặc video ngắn.
- Mở Text to Speech trong danh sách ghim ở sidebar.
- Dán hoặc gõ kịch bản vào ô văn bản chính. Bộ đếm bên dưới hiển thị số ký tự đã dùng (kịch bản của tôi là 149 / 10.000).
- Chọn giọng trong bảng Voice. Dashboard còn gợi ý vài giọng ở mục "Recommended for your text", là cách nhanh để nghe thử.
- Kiểm tra dòng Model. v4 được chọn sẵn, và bảng chọn giải thích từng lựa chọn.
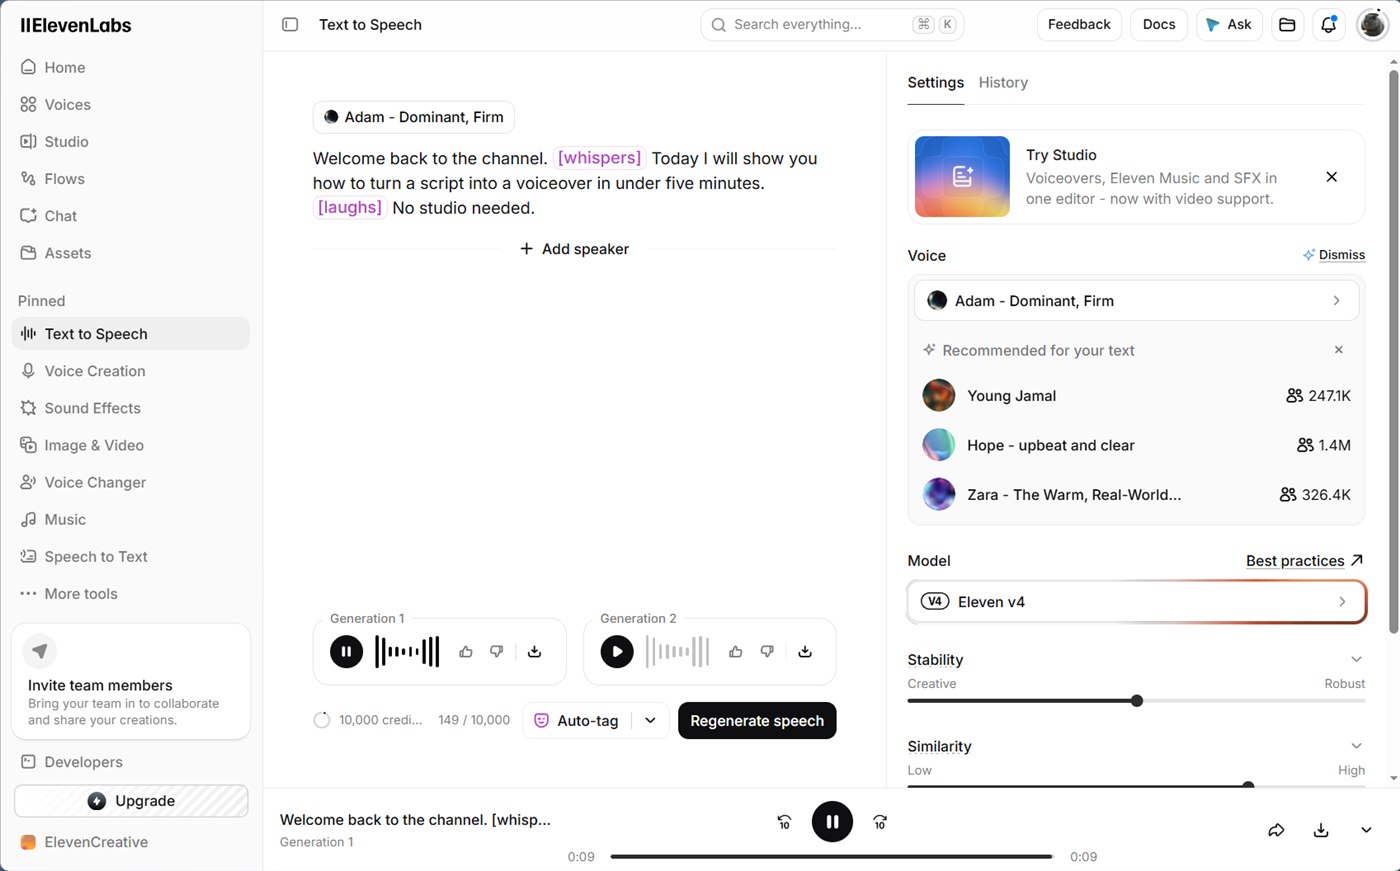
- Có thể chỉnh Stability (từ Creative đến Robust) và Similarity (từ Low đến High). v4 chỉ có hai thanh trượt này, không có điều chỉnh tốc độ.
- Bấm Generate speech, rồi nghe và tải về từ các thẻ kết quả.
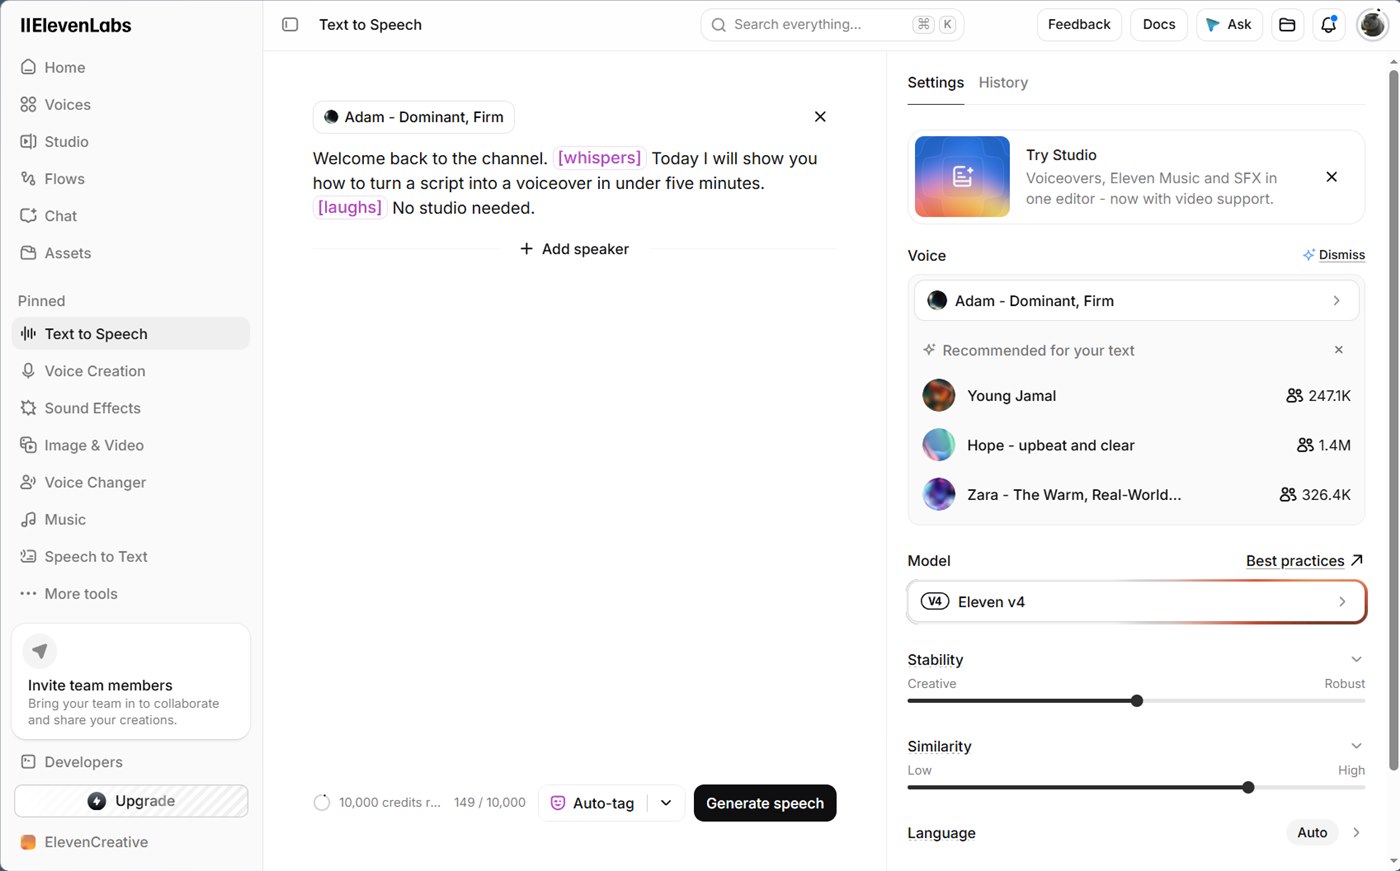
Kịch bản tôi dùng có hai audio tag, [whispers] và [laughs], viết trong ngoặc vuông ngay giữa câu. Khi chọn v4 hoặc v3, trình soạn thảo tô màu tím cho các tag này. Tag quyết định cách đọc các từ đứng sau nó, nên hãy đặt đúng chỗ người đọc thật sẽ đổi giọng. Nút Auto-tag cạnh nút Generate sẽ tự chèn tag giúp bạn, nhưng hãy coi kết quả là bản nháp đầu để sửa tay.
Nghe thử đoạn mẫu bên dưới: một câu ngắn tạo bằng giọng Adam với tag [whispers]. Đây chỉ là một lần tạo, nên nó cho thấy tag làm gì, không đại diện cho mọi giọng.
Bấm vào dòng Model sẽ mở bảng chọn với ba lựa chọn chính:
Mỗi lần bấm Generate cho ra hai bản đọc của cùng kịch bản, hiển thị thành Generation 1 và Generation 2, có nút thích, không thích và tải về. Sau đó nút đổi thành Regenerate speech.
Để tiết kiệm credit:
- Soát lỗi chính tả trước, và làm việc này miễn phí: dán kịch bản vào một công cụ chat miễn phí như ChatGPT hoặc Gemini, yêu cầu chỉ sửa chính tả. Model đọc đúng những gì bạn gõ nên một lỗi chính tả sẽ thành một từ đọc sai, và mỗi lần tạo lại để sửa đều tốn credit.
- Viết số và ký hiệu thành chữ khi chúng quan trọng ("hai nghìn không trăm hai mươi sáu" thay cho "2026").
- Nghe thử một đoạn ngắn trước, khi giọng và tag đã ổn thì mới dán toàn bộ kịch bản.
- Theo tài liệu của ElevenLabs, bạn được tạo lại miễn phí hai lần trên web, với điều kiện văn bản, giọng và model không đổi, lần tạo đầu chưa quá hai giờ và trang chưa bị tải lại. Làm mới tab là mất hai lần này.
- Kịch bản dài hơn giới hạn của một lần tạo thì nên chuyển sang Studio, nơi có timeline và xử lý lời bình dài.
Hãy nghe cả hai bản trước khi chọn, vì nhìn kịch bản thì không biết tag có thật sự đổi cách đọc hay không.
Chuyển âm thanh hoặc video thành văn bản (Speech to Text)
Mục tiêu: có bản transcript kèm mốc thời gian từ âm thanh hoặc video.
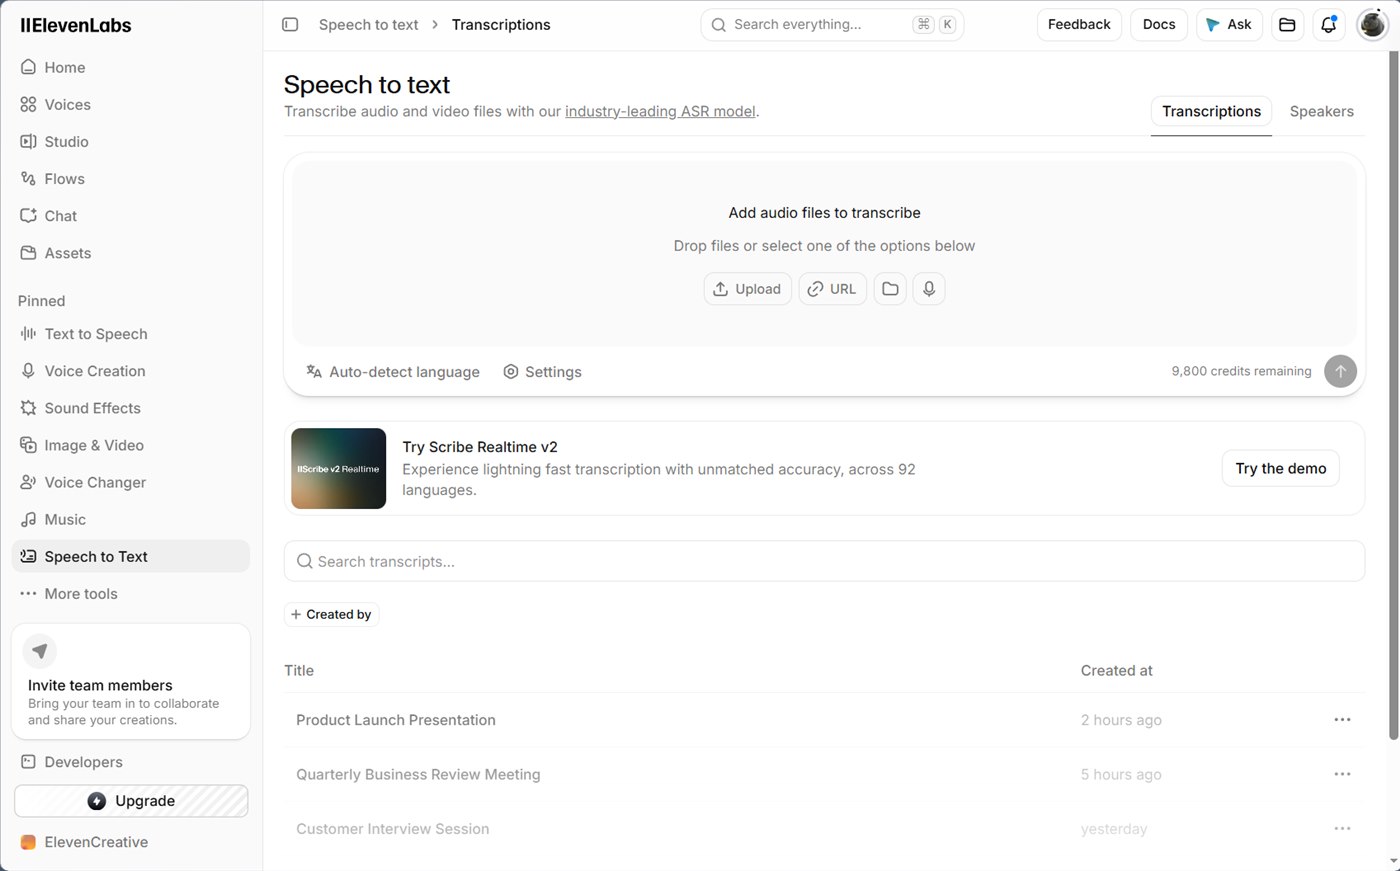
- Mở Speech to Text. Trang này là giao diện của Scribe và đang quảng bá Scribe Realtime v2 với 92 ngôn ngữ.
- Thả tệp vào, hoặc chọn Upload, URL, biểu tượng thư mục (cho tài nguyên có sẵn) hay micro để ghi âm.
- Giữ Auto-detect language ở trạng thái bật, hoặc chọn một ngôn ngữ.
- Mở Settings để tinh chỉnh đầu ra.
Bảng cài đặt có năm mục:
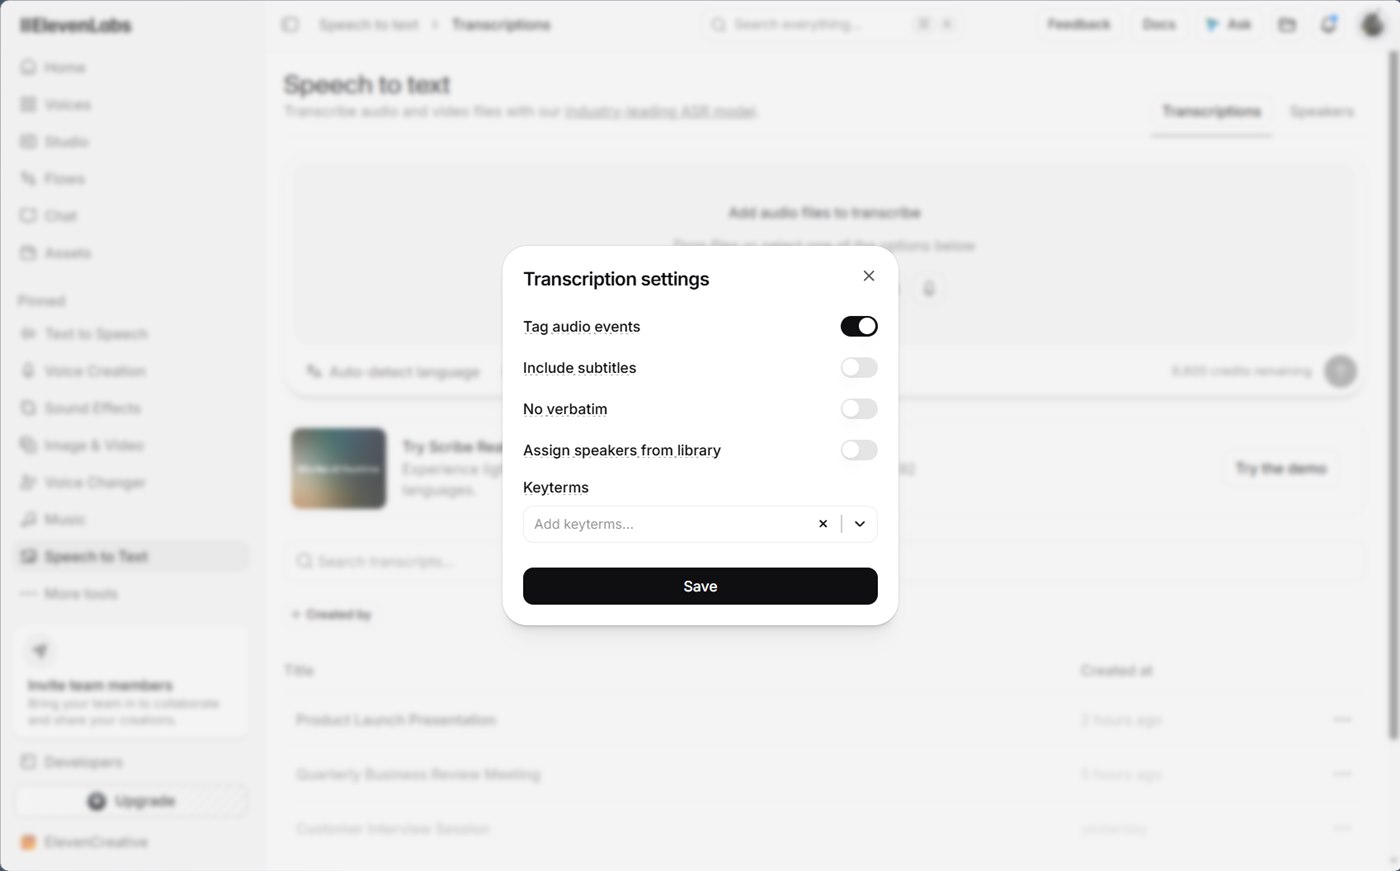
- Tag audio events bật sẵn và đánh dấu các âm thanh như tiếng cười trong bản transcript.
- Include subtitles khởi tạo dự án với một track phụ đề có thể chỉnh sửa, phù hợp khi làm video.
- No verbatim bỏ từ đệm và các câu bỏ dở.
- Assign speakers from library ghép người nói với các giọng bạn đã lưu.
- Keyterms nhận tên sản phẩm và thuật ngữ để model viết đúng chính tả. Tài liệu ghi chú việc dùng keyterm tốn thêm phí.
Tài liệu xếp tiếng Việt vào nhóm "Excellent" của Scribe v2, nghĩa là tỷ lệ lỗi từ không quá 5%. Đó là thước đo do chính nhà cung cấp đưa ra. Muốn biết nó xử lý accent và chất lượng âm thanh của bạn tới đâu, cách nhanh nhất là thử mười phút trên bản ghi thật của bạn. Tôi đã mở màn hình và cài đặt nhưng chưa chạy thử chuyển giọng nói thành văn bản.
Đọc kịch bản dài hoặc dựng video (Studio)
Mục tiêu: đọc một nội dung dài hơn một lần tạo của Text to Speech, ví dụ một chương sách nói, một tập podcast hoặc video có lời bình, nhạc và phụ đề trong cùng một nơi.
Studio là trình chỉnh sửa nhiều track nằm trong sidebar. Ngày 2026-10-21, trang bắt đầu của nó hỏi "What would you like to create?" và có năm cách vào việc:
- Gõ mô tả vào thanh Create. Tài liệu ghi Studio 4.0 làm việc theo kiểu prompt trước: bạn mô tả dự án và Studio Agent dựng bản nháp đầu.
- Bấm dấu cộng trong thanh Create để đính kèm tệp, ví dụ một kịch bản.
- Chọn một Inspiration, tức một template mẫu.
- Bấm Upload để bắt đầu từ tài liệu hoặc media của bạn.
- Bấm New blank project để bắt đầu từ trang trống.
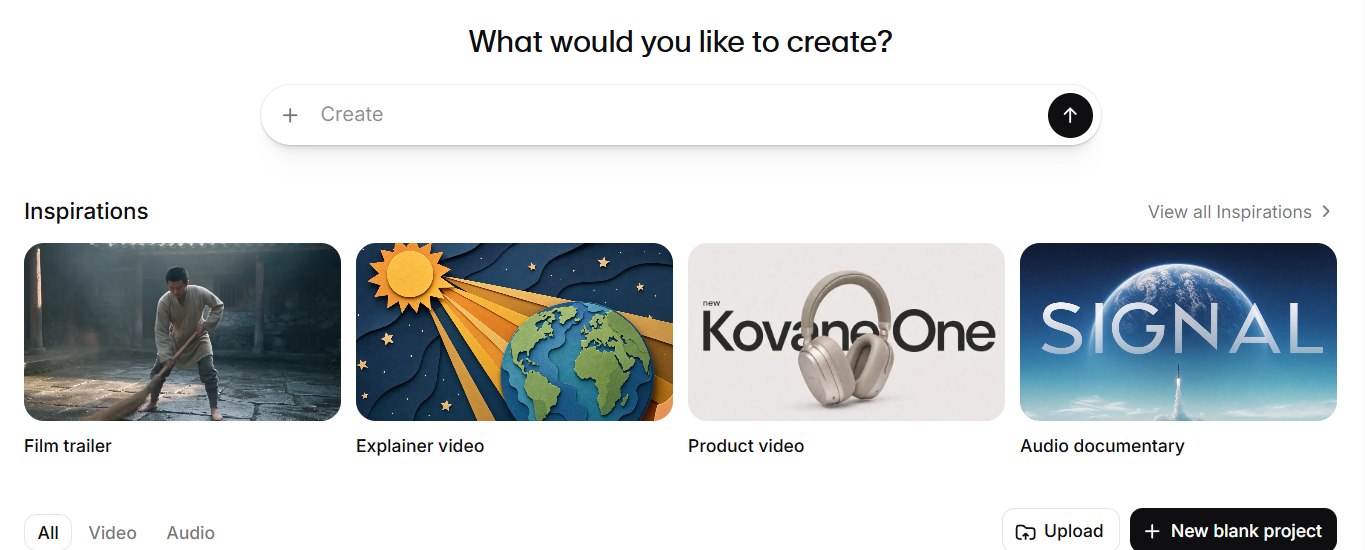
View all Inspirations mở danh sách đầy đủ bảy template: Film trailer, Explainer video, Product video, Audio documentary, How to tutorial, Audio podcast và Captions.
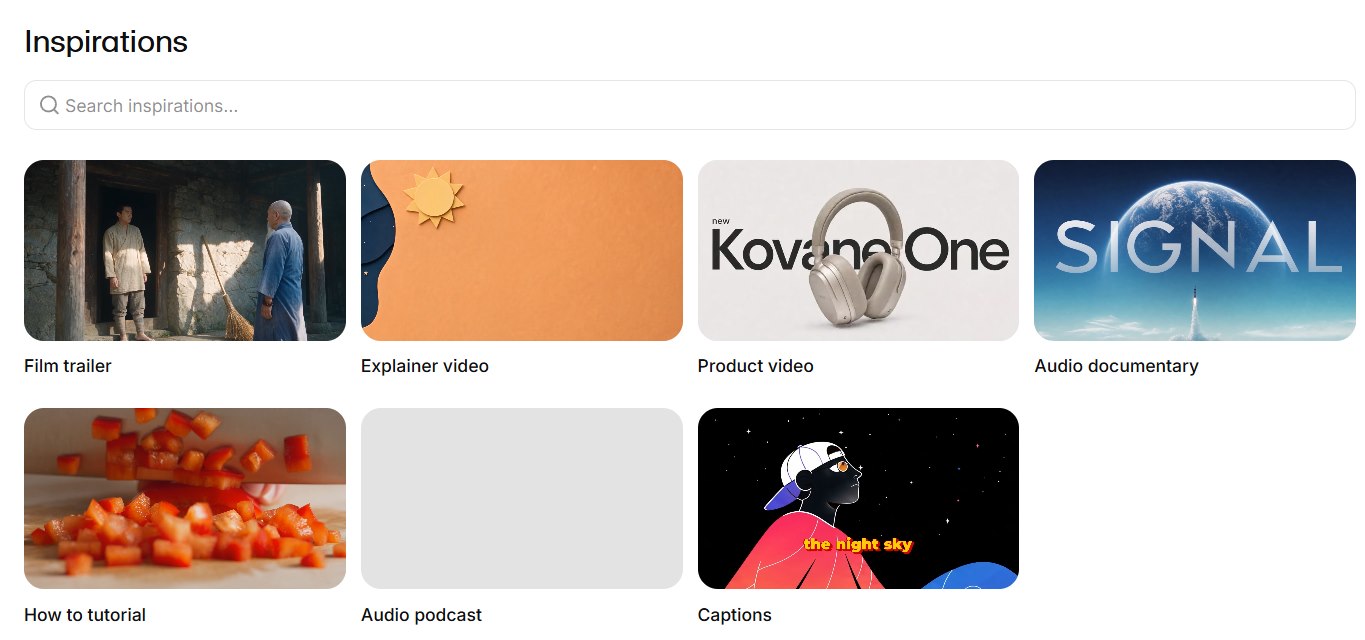
Bên dưới các template, các tab All, Video và Audio lọc các dự án gần đây, kèm ô tìm kiếm và chế độ xem danh sách hoặc lưới.
Tài liệu mô tả hai loại dự án. Dự án âm thanh hợp với lời bình dài, podcast và sách nói. Dự án video gộp clip, hình ảnh, giọng nói, nhạc, hiệu ứng âm thanh và phụ đề. Những tính năng đáng dùng khi đọc một nội dung dài:
- Timeline nhiều track với trim, split và duplicate.
- Thanh chapters cho dự án âm thanh. Chapter được nhận diện tự động khi bạn nhập tài liệu có sẵn chapter, với giới hạn 500 chapter mỗi dự án, 400 đoạn mỗi chapter và 5.000 ký tự mỗi đoạn.
- Mỗi phần dùng một giọng khác nhau, mỗi giọng có một màu đánh dấu, kèm lệnh "Replace voice across project" để đổi giọng trên toàn dự án.
- Pronunciations Editor để đặt quy tắc alias hoặc phoneme. Thẻ phoneme chỉ hoạt động với Eleven Flash v2.
- Lịch sử các lần tạo, khóa đoạn và "Insert break" để chèn quãng nghỉ tối đa 3 giây.
Chi phí và giới hạn gói, cũng theo tài liệu đó: Studio có trên gói miễn phí, với giới hạn 5 dự án và watermark trên video xuất ra. Đọc lời bình tốn credit, còn nghe lại âm thanh đã có thì miễn phí. Mỗi đoạn được tạo lại miễn phí tối đa hai lần nếu văn bản, giọng và cài đặt giọng không đổi. Khi xuất, chỉ những đoạn chưa được chuyển thành giọng mới tốn credit. Các gói Free, Starter và Creator xuất MP3 128 kbps. Chat với agent trong Studio tính credit theo lượng token, còn media được tạo ra tính phí riêng.
Tôi mở trang bắt đầu và danh sách template nhưng chưa tạo dự án nào, nên không thể nói bản nháp đầu do agent dựng trông ra sao hay tốn bao nhiêu.
Tạo hiệu ứng âm thanh từ một câu mô tả
Mục tiêu: tạo một hiệu ứng ngắn, ví dụ tiếng gõ phím cơ đặt dưới đoạn quay màn hình.
- Mở Sound Effects. Tab Explore có thư viện để duyệt theo danh mục (Animals, Bass, Booms, Brass, Cymbals và nhiều mục khác).
- Bấm vào thanh prompt ở cuối trang và mô tả âm thanh: "Mechanical keyboard typing in a quiet office, close up."
- Đặt các tùy chọn trên thanh prompt: lặp (mặc định tắt), thời lượng (mặc định Auto) và mức bám prompt (mặc định 30%). Mức bám cao thì model bám sát câu chữ hơn, mức thấp cho model nhiều tự do hơn.
- Bấm Generate sound effect.
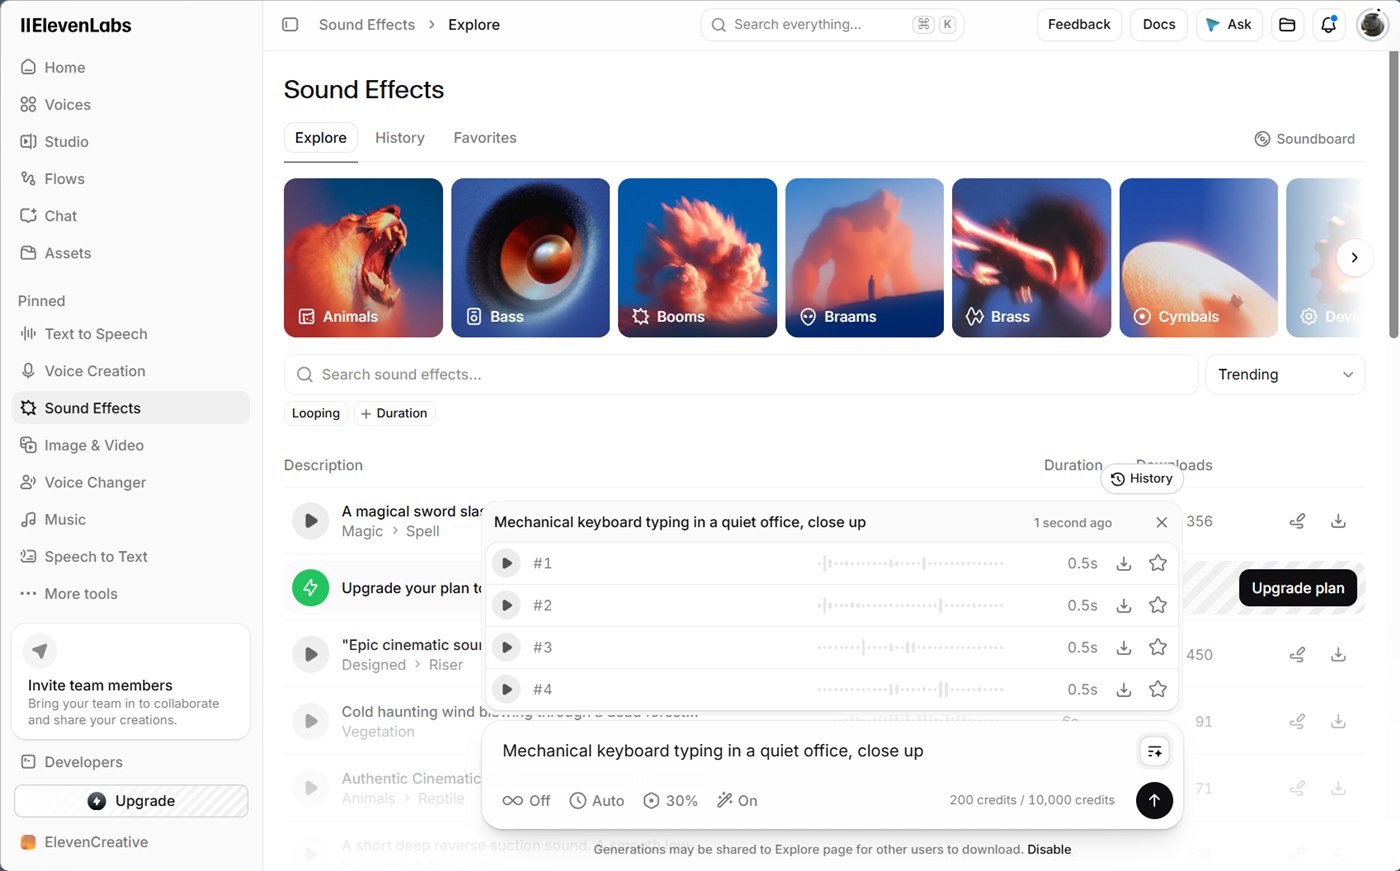
Kết quả là bốn biến thể, mỗi biến thể có nút phát, tải về và yêu thích. Khi để thời lượng ở Auto, model trả về các đoạn dài 0,5 giây cho prompt tiếng gõ phím, quá ngắn để đặt dưới đoạn quay màn hình. Khi cần một lớp âm nền, hãy đặt thời lượng cụ thể. Tài liệu ghi thời lượng từ 0,1 đến 30 giây, và thời lượng cố định tốn 40 credit mỗi giây, nên hiệu ứng 10 giây là 400 credit.
Trang còn hiện hai thông báo dễ bỏ sót:
- Ở cuối trang, gói miễn phí hiện dòng "Generations may be shared to Explore page for other users to download", kèm liên kết Disable. Hãy coi prompt trên gói miễn phí là công khai.
- Trên tài khoản của tôi, các mục trong thư viện Explore hiện dòng "Upgrade your plan to download sound effects". Hãy kiểm tra xem clip tự tạo có tải về được trên gói của bạn không trước khi lên kế hoạch cho dự án.
Tạo nhạc nền từ một câu mô tả
Trang Music tạo bản nhạc từ prompt, kèm một marketplace các bản có sẵn lọc được theo thể loại, nhạc cụ và tâm trạng.
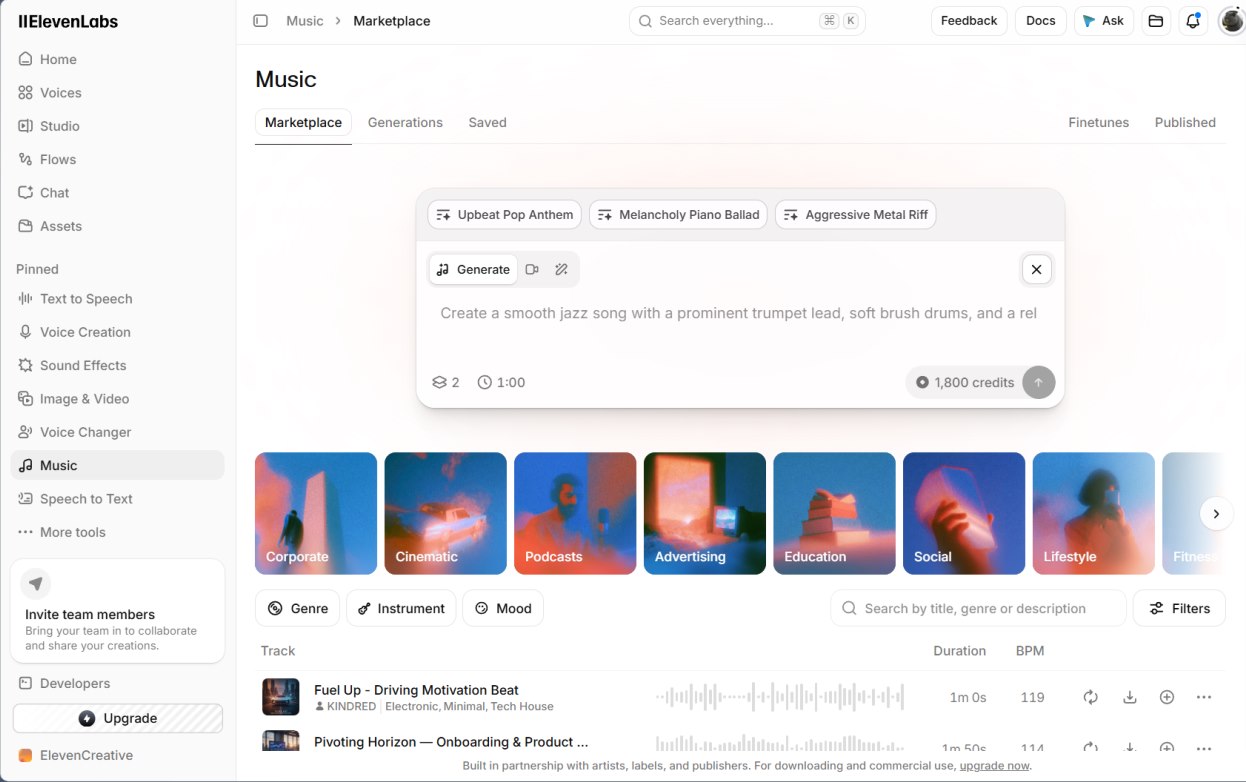
Thanh prompt hiện chi phí trước khi bấm: 1.800 credit cho hai bản nhạc một phút, tức khoảng một phần năm hạn mức miễn phí chỉ trong một lần tạo. Dòng chân trang ghi "For downloading and commercial use, upgrade now", nên gói miễn phí chỉ dùng để nghe thử. Tôi chưa tạo bản nhạc nào.
Tạo hoặc nhân bản giọng riêng cho kênh của bạn
Mục tiêu: một giọng người dẫn nhất quán thay cho giọng có sẵn.
Mở Voice Creation. Trang đưa ra bốn hướng, đặt cạnh nhau:
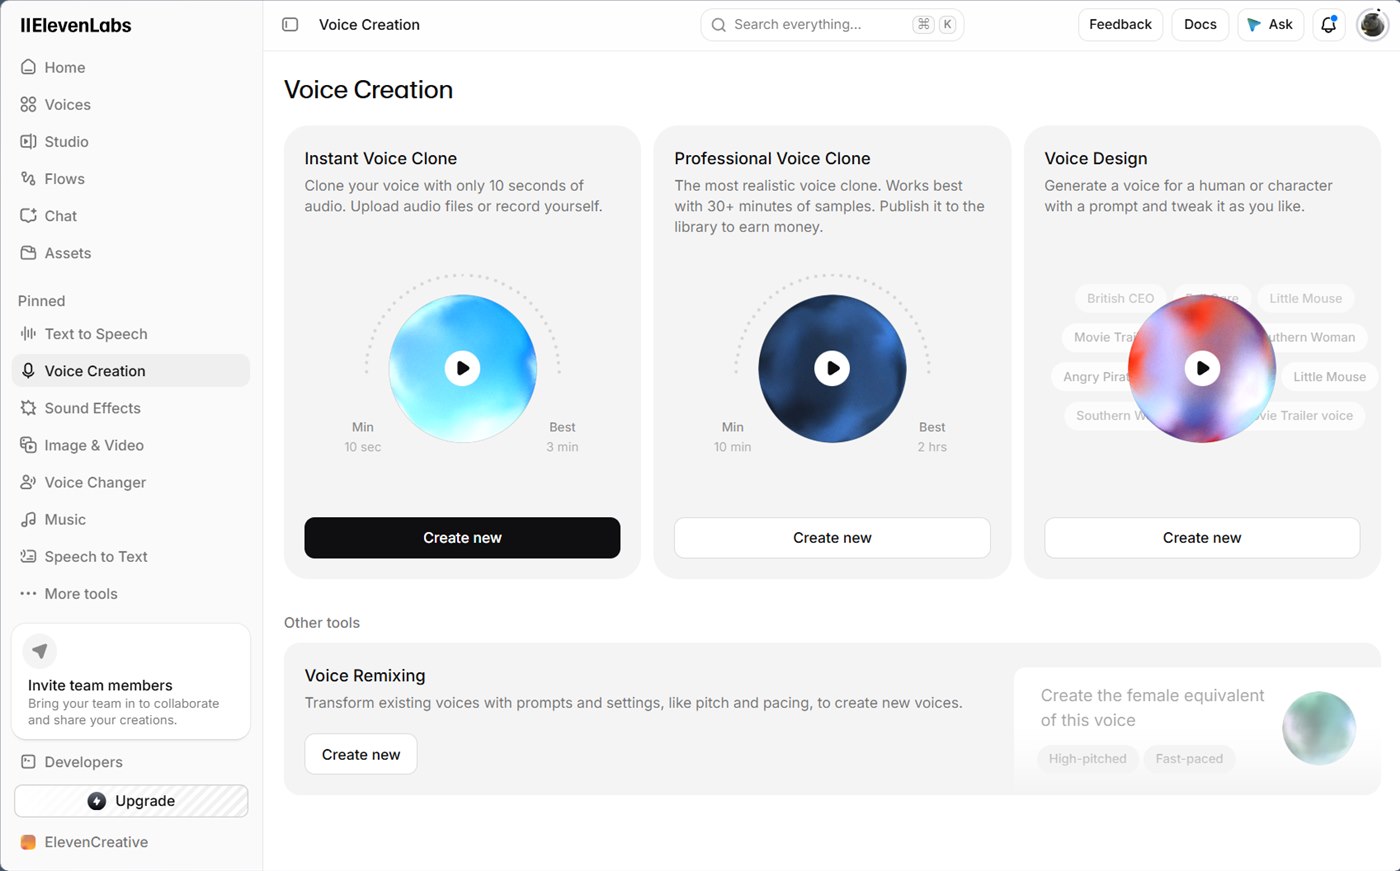
| Hướng | Đầu vào cần có | Phù hợp khi |
|---|---|---|
| Instant Voice Clone | Tối thiểu 10 giây, tốt nhất khoảng 3 phút | Bạn muốn nhân bản nhanh giọng của chính bạn |
| Professional Voice Clone | Tối thiểu 10 phút, tốt nhất đến 2 giờ, "works best with 30+ minutes" | Bạn cần bản sao giống nhất để dùng lâu dài |
| Voice Design | Một prompt văn bản | Bạn muốn một giọng mới mà không cần thu âm |
| Voice Remixing | Một giọng có sẵn cộng prompt | Bạn thích một giọng nhưng muốn đổi cao độ hoặc nhịp |
Tôi thử Voice Design, hướng duy nhất không cần thu âm. Hộp thoại mở ra với ô prompt và các gợi ý mẫu. Hãy viết prompt như một bản mô tả casting: giới tính, độ tuổi, giọng vùng miền, chất lượng âm thanh, nhịp nói và mục đích dùng. Cách nghĩ này giống với prompt engineering: nêu rõ công việc, ràng buộc và định dạng. Prompt của tôi:
A warm, calm female narrator in her thirties with a neutral American accent. Clear studio-quality audio. Friendly, unhurried pace, suited for tutorial videos and podcast intros.
Bấm Generate voice, hộp thoại trả về ba ứng viên: Voice 1, 2 và 3.
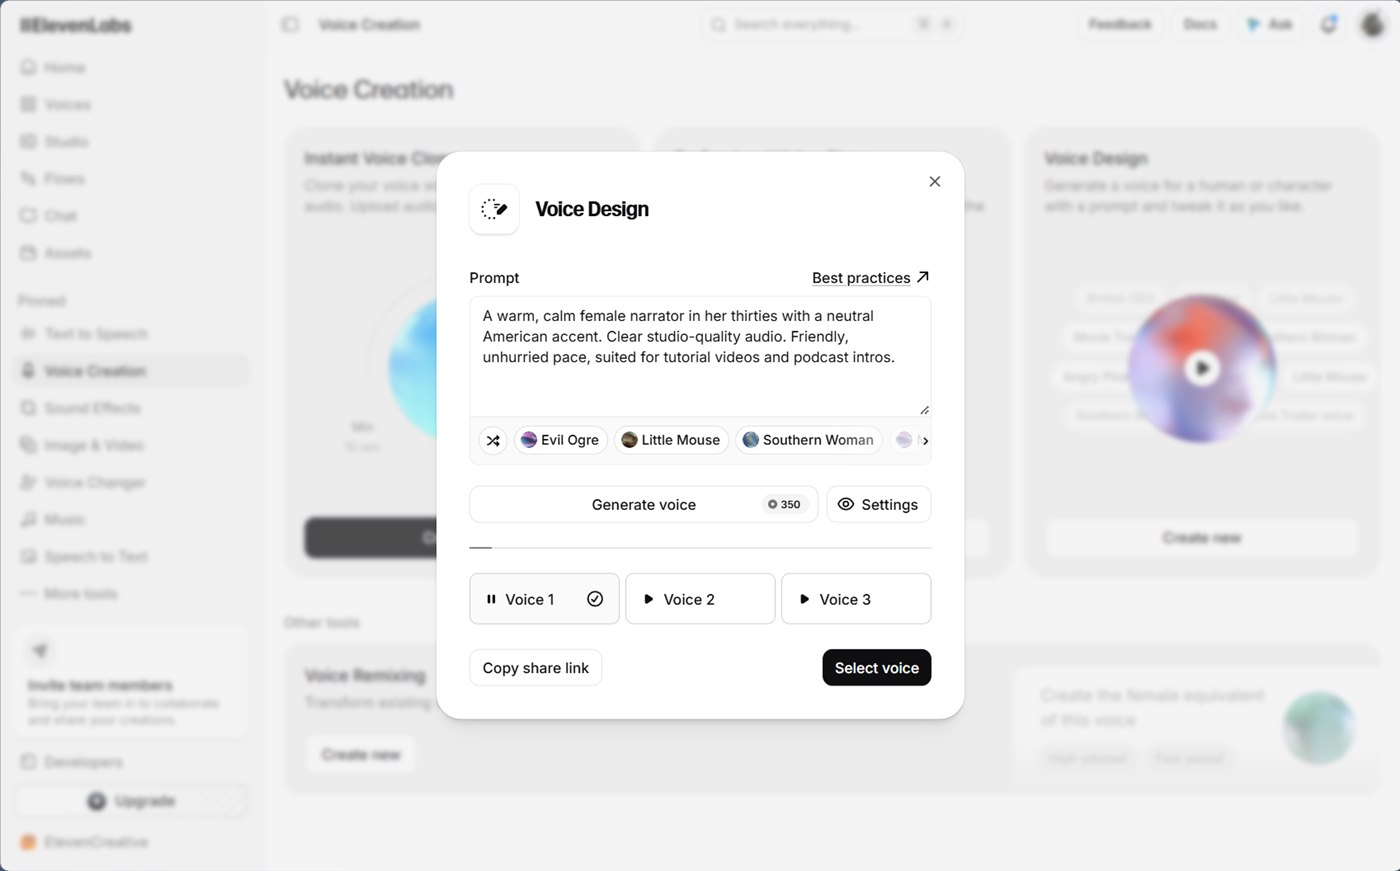
Bạn trả phí một lần cho đoạn văn xem thử, rồi thoải mái so sánh ba ứng viên. Select voice lưu một giọng vào thư viện và chiếm một slot giọng, nên tôi dừng trước bước đó.
Trước khi clone một giọng, hãy kiểm tra ba quy tắc về sự đồng ý:
- Instant Voice Clone yêu cầu bạn xác nhận có quyền sử dụng giọng đó và đã được người nói đồng ý.
- Professional Voice Clone yêu cầu xác minh giọng và chỉ dùng cho giọng của chính bạn.
- Chính sách sử dụng của ElevenLabs cấm sao chép giọng của người còn sống khi chưa có sự đồng ý rõ ràng, cấm dùng bản ghi giọng của người dưới 18 tuổi, và cấm mạo danh hay lừa đảo.
Lồng tiếng video sang ngôn ngữ khác (Dubbing)
Mục tiêu: đăng cùng một video cho nhóm người xem thứ hai mà không phải thu âm lại.
- Mở Dubbing (nằm trong More tools, hoặc vào thẳng
app/dubbing). - Thêm nguồn bằng Select files, hoặc dùng biểu tượng quả địa cầu để dán đường dẫn video.
- Xem chip model. Mặc định hiện là v2, thẻ giới thiệu gắn nhãn alpha. Thẻ này ghi hỗ trợ 92 ngôn ngữ, hứa giữ nguyên cảm xúc và cách nói của người nói gốc, điều chỉnh cách diễn đạt cho tự nhiên và tự động clone giọng người nói.
- Bấm Choose languages và tìm ngôn ngữ đích.
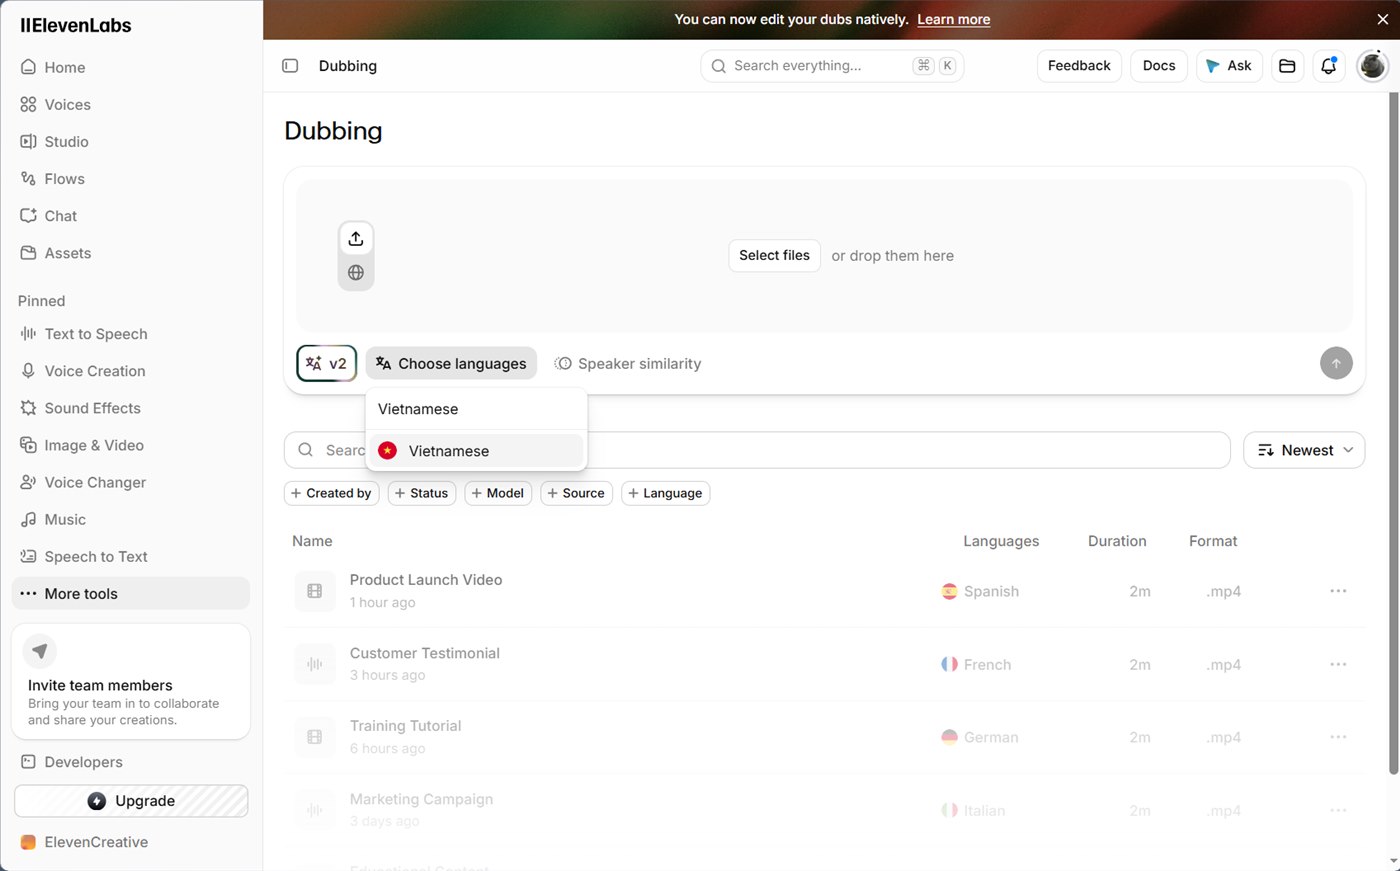
- Mở Speaker similarity và đặt thanh trượt. Bảng này giải thích sự đánh đổi: đặt cao thì giữ accent của giọng gốc, đặt thấp thì nghe tự nhiên hơn trong ngôn ngữ đích.
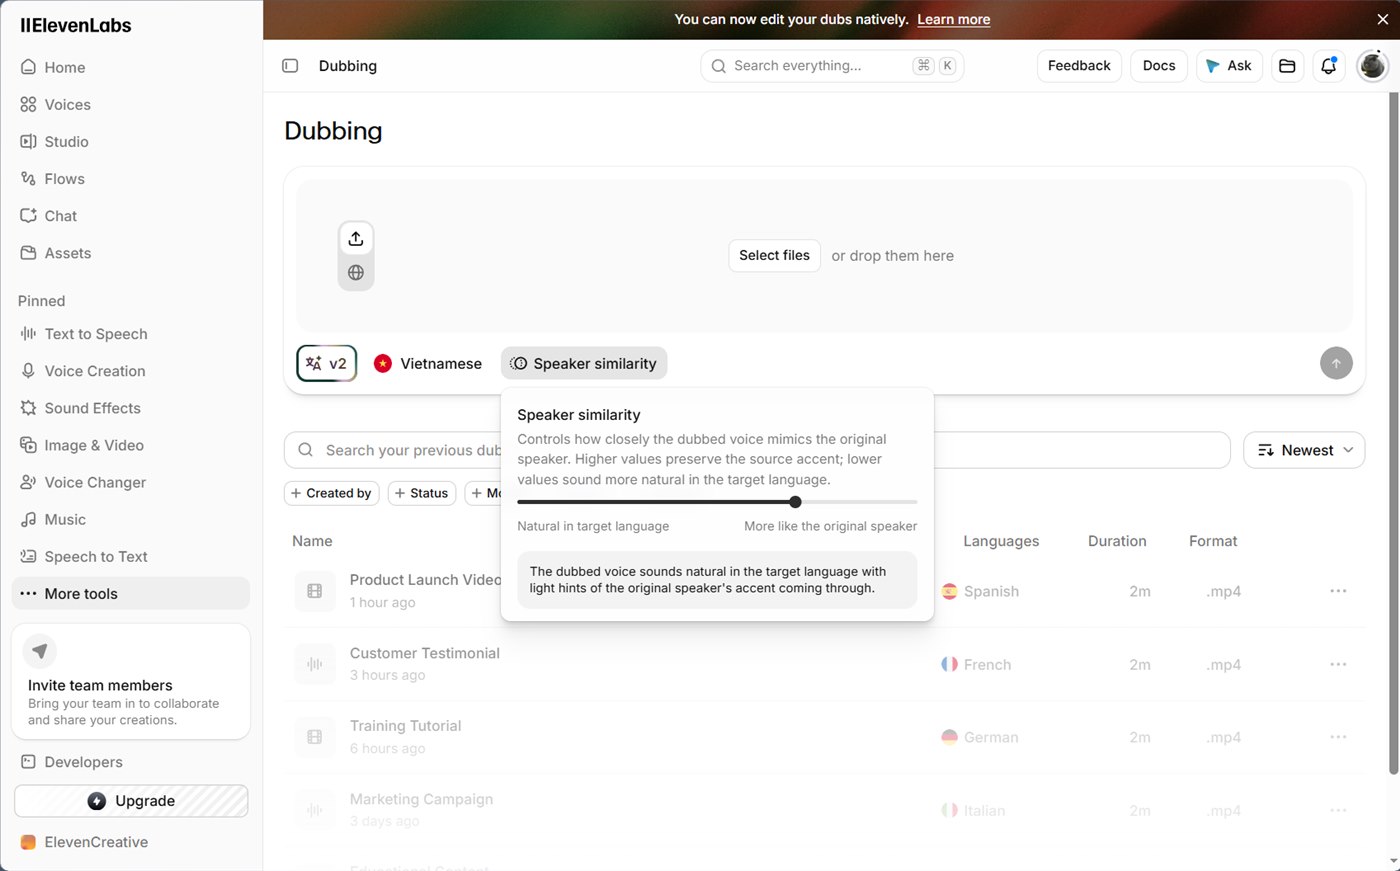
- Gửi bằng nút mũi tên, rồi xem lại bản transcript và bản lồng tiếng trước khi đăng.
Tôi chưa gửi job nên chưa có bản lồng tiếng hoàn chỉnh để cho bạn xem. Các con số quyết định chi phí lấy từ tài liệu và trang pricing: phí tính theo mỗi phút media nguồn cho từng ngôn ngữ đích, và ứng dụng hiển thị tổng chi phí trước khi job bắt đầu. Bản tự động có watermark tốn 2.000 credit mỗi phút, bản không watermark 3.000, nên 10.000 credit miễn phí đủ cho năm phút nguồn sang một ngôn ngữ có watermark. Ứng dụng nhận tệp tối đa 1 GB hoặc 180 phút, và tối đa 32 người nói.
Cả hai thế hệ dubbing đều hỗ trợ tiếng Việt. Hãy đọc bản dịch trước khi xuất. Tên riêng, thuật ngữ sản phẩm và con số thường là nơi bản lồng tiếng tự động sai trước tiên.
Làm voice agent trả lời điện thoại
Mục tiêu: một agent trả lời câu hỏi thường gặp, nhận lời nhắn và chuyển cuộc gọi cho một doanh nghiệp nhỏ.
Chuyển sang nền tảng Agents bằng nút chuyển nền tảng ở sidebar. Màn hình đầu tiên là danh sách tám template, gồm Customer Support, Language Practice, Front Desk Receptionist, Inbound Lead Qualification, Hotel Reservation và một trợ lý bán hàng thương mại điện tử, cùng nút Create Blank Agent.
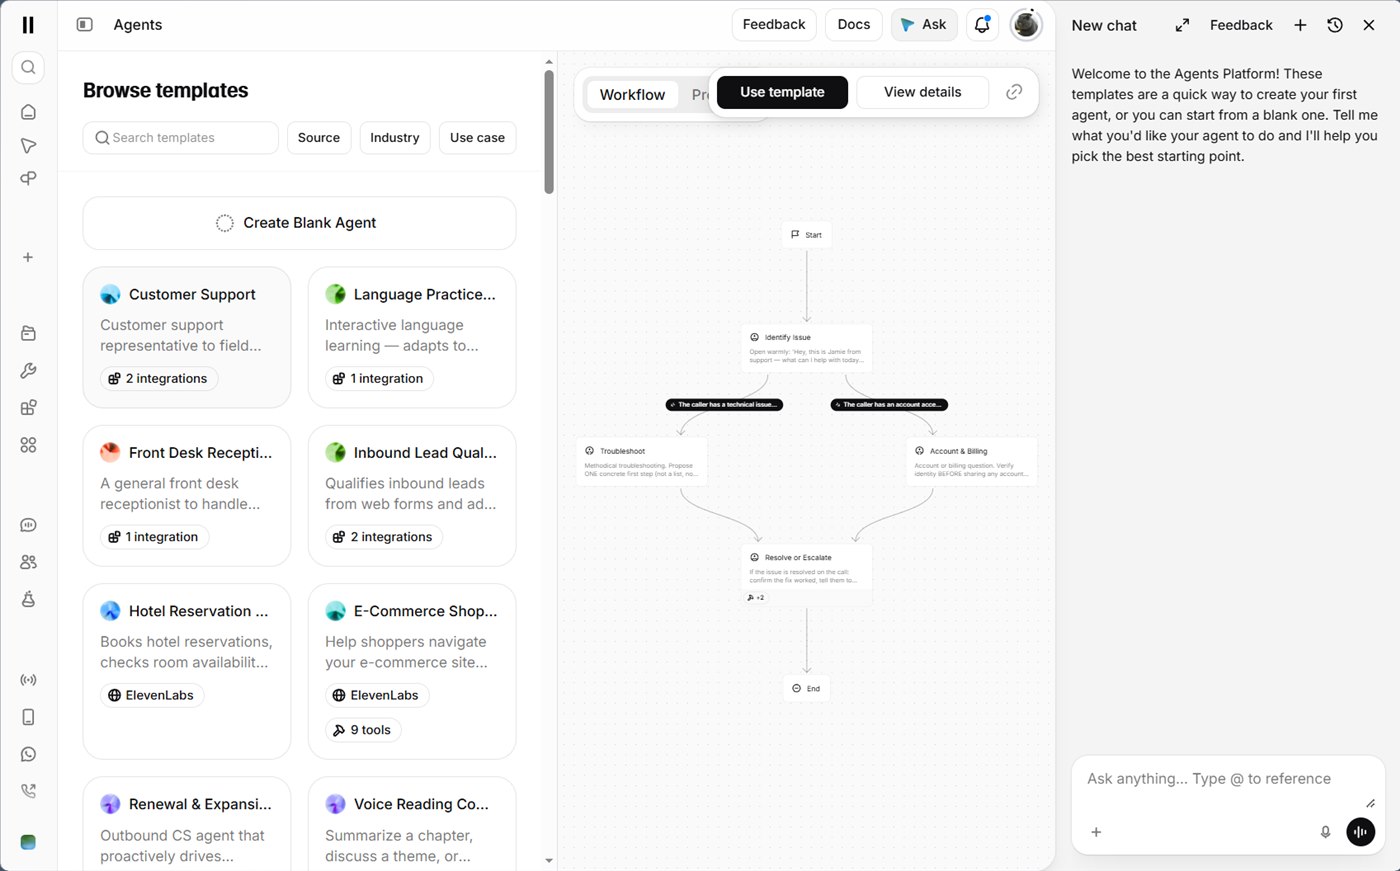
Bấm vào Front Desk Receptionist sẽ mở bản xem trước workflow và chưa tạo gì cả. Sơ đồ bắt đầu bằng bước chào và nhận diện ý định, rồi chia thành ba nhánh: trả lời câu hỏi thường gặp, chuyển cuộc gọi, hoặc nhận lời nhắn. Cả ba nhánh dồn về bước kết thúc để xác nhận lại việc đã làm.
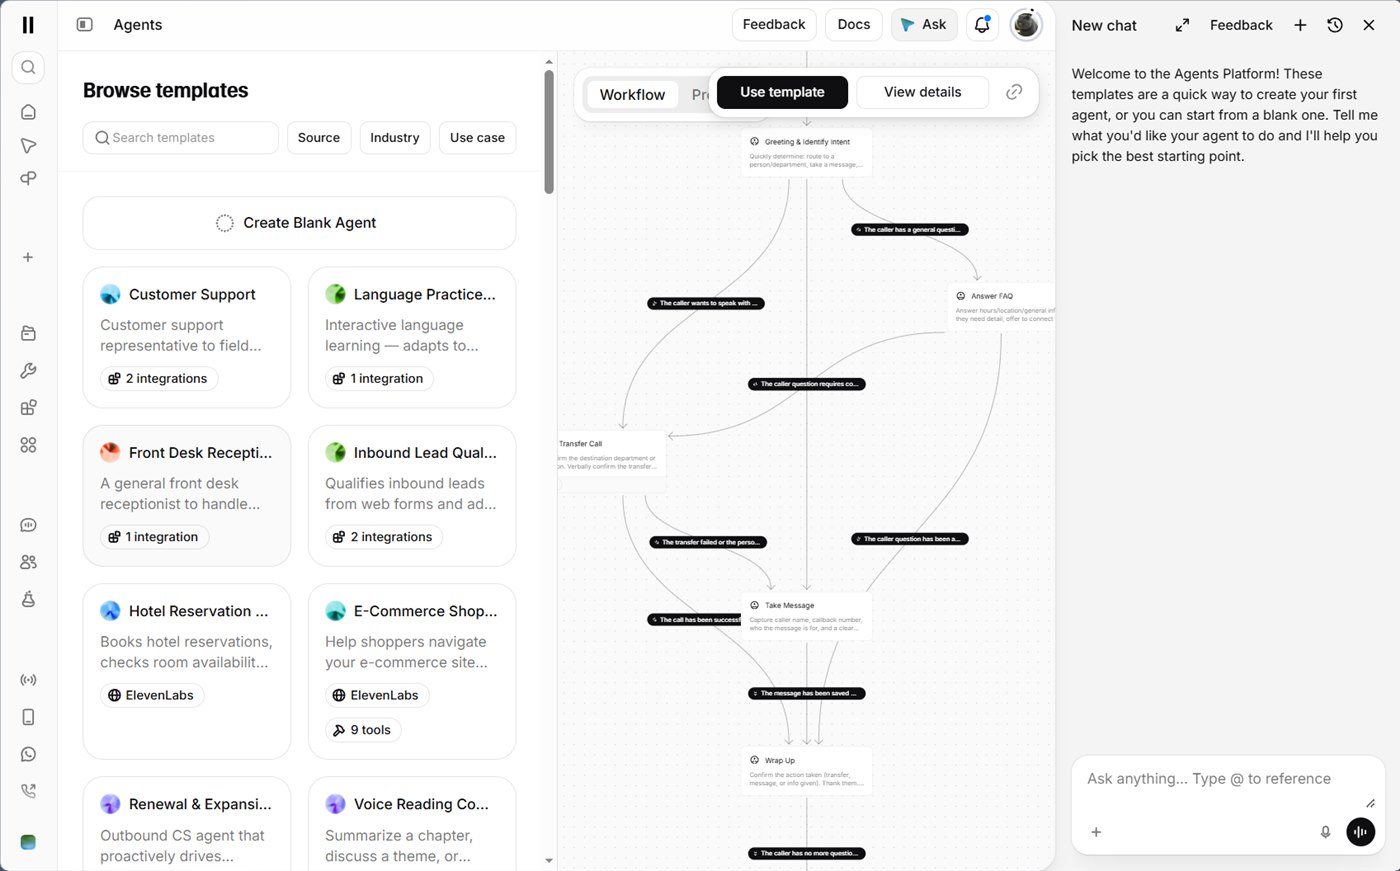
Để biến template thành agent của riêng bạn:
- Bấm Use template.
- Sửa prompt của từng node để lời chào, giờ làm việc và chính sách khớp với doanh nghiệp của bạn.
- Thêm nội dung của bạn vào knowledge base (tài liệu, văn bản hoặc URL) để câu trả lời đến từ tài liệu của bạn thay vì kiến thức chung của model. Ở bước này, một bảng thuật ngữ ngắn về sản phẩm sẽ có ích, lý do có trong bài vì sao AI agent cần glossary theo lĩnh vực.
- Chọn giọng và ngôn ngữ, rồi nói chuyện với agent ngay trong dashboard trước khi kết nối bất cứ thứ gì.
- Chạy các bài test có sẵn với những kịch bản bạn quan tâm, rồi triển khai qua web widget, SDK hoặc số điện thoại.
Các bước chỉnh sửa và triển khai ở trên lấy từ tài liệu ElevenAgents chứ không phải từ lần chạy của tôi. Tài liệu cho biết dựng agent đầu tiên mất khoảng năm phút. Agent tính phí theo từng phút chạy. Trang pricing ghi $0,08 cho mỗi phút phát sinh thêm (chi phí LLM và viễn thông tính riêng và cộng thêm vào) và $0,16 mỗi phút khi vượt giới hạn chạy đồng thời. Vì chi phí này chạy liên tục, hãy ước lượng số cuộc gọi mỗi ngày trước khi công bố số điện thoại.
Tính năng nào hợp với việc nào
| Việc cần làm | Tính năng | Tôi đã chạy | Tín hiệu chi phí |
|---|---|---|---|
| Đọc kịch bản | Text to Speech (v4) | Có | Tính theo ký tự |
| Lời bình dài hoặc dự án video | Studio | Chỉ trang bắt đầu | Credit cho mỗi đoạn được tạo |
| Âm thanh ngắn dưới clip | Sound Effects | Có | 200 credit mỗi lần chạy thời lượng tự động |
| Giọng người dẫn nhất quán | Voice Design | Có | Giá hiện trên nút |
| Video sang ngôn ngữ thứ hai | Dubbing (v2 alpha) | Chỉ đến bước cài đặt | 2.000 đến 3.000 credit mỗi phút |
| Bản transcript hoặc phụ đề | Speech to Text (Scribe) | Chỉ đến bước cài đặt | Tính theo giờ âm thanh trên API |
| Trả lời điện thoại và chat | ElevenAgents | Chỉ xem trước | $0,08 mỗi phút phát sinh thêm |
| Nhạc mở đầu | Music | Chỉ đến bước cài đặt | 1.800 credit cho hai bản |
Khi nào chưa cần ElevenLabs
Nếu chỉ cần đọc một đoạn lời bình ngắn, một công cụ miễn phí khác có thể đã đủ. ElevenLabs đáng trả tiền khi giọng phải diễn cảm, khi bạn cần nhân bản giọng, lồng tiếng hoặc gọi API. Số liệu dưới đây lấy từ trang của từng nhà cung cấp, kiểm tra ngày 21/10/2026. Tôi chưa so sánh chất lượng giọng đọc, vì việc đó cần nghe thử và bài này chưa tạo mẫu nào để đặt cạnh nhau.
| Công cụ | Hạn mức miễn phí | Dùng thương mại | Hợp khi |
|---|---|---|---|
| CapCut text to speech | Trang không nêu giới hạn ký tự | Phần FAQ nói được, theo điều khoản của CapCut | Lời bình đi thẳng vào bản dựng CapCut, đỡ một bước xuất file |
| TTSMaker | 20.000 ký tự mỗi tuần, một số giọng không giới hạn | Trang nói được dùng thương mại hợp pháp | Lời bình ngắn, không cần tài khoản, không cần chỉnh cảm xúc |
| Azure AI Speech | 500.000 ký tự mỗi tháng ở gói F0 | Đọc điều khoản Azure cho trường hợp của bạn | Bạn là lập trình viên và cần API miễn phí |
| Fish Audio | Theo các trang tổng hợp: 8.000 credit mỗi tháng, tối đa 500 ký tự mỗi lần tạo | Các nguồn nói khác nhau, hãy đọc điều khoản hiện hành | Bạn muốn thử nhân bản giọng trước khi quyết định trả tiền |
| ElevenLabs gói Free | 10.000 credit mỗi tháng | Không, gói Free phải ghi nguồn | Bạn cần audio tag, v4, dubbing hoặc Scribe |
Cách chọn nhanh:
- Dùng công cụ miễn phí khác nếu kịch bản ngắn, giọng chỉ cần rõ chữ và bạn không cần chỉnh cảm xúc.
- Chọn ElevenLabs nếu giọng đọc là điểm nhấn của video, như kênh kể chuyện, quảng cáo hay nhân vật, hoặc nếu bạn muốn làm lời bình, transcript và lồng tiếng trong cùng một nơi.
- Đọc điều khoản thương mại của công cụ bạn chọn trước khi đăng video. Điều khoản hay thay đổi, và gói Free của ElevenLabs cũng không cho dùng thương mại.
Dùng thương mại, quyền riêng tư và giới hạn
- Theo tài liệu thanh toán của ElevenLabs, đầu ra trên gói miễn phí không dùng cho mục đích thương mại và cần ghi nguồn. Giấy phép thương mại bắt đầu từ gói Starter. Hãy kiểm tra điều khoản của gói trước khi kiếm tiền từ sản phẩm có dùng đầu ra này.
- Các hiệu ứng âm thanh tạo trên gói miễn phí có thể xuất hiện trên trang Explore công khai, như thông báo trong giao diện cho biết. Nếu kịch bản có nội dung nhạy cảm, hãy dùng gói trả phí và đọc chính sách quyền riêng tư. Nếu kịch bản không được rời khỏi máy của bạn, model self-host sẽ an toàn hơn, cách làm có trong hướng dẫn chạy AI cục bộ với LM Studio.
- Chính sách sử dụng yêu cầu thông báo cho người dùng biết họ đang tương tác với AI ở nơi luật pháp đòi hỏi, và quy định này áp dụng cả cho voice agent trả lời cuộc gọi.
- Theo ElevenLabs, video lồng tiếng của nhà sáng tạo nội dung Drew Binsky đạt trung bình 2,6M lượt xem, so với 1,1M của video không lồng tiếng, còn Kompf24 giảm thời gian chờ từ 90 giây xuống khoảng 15 giây nhờ voice agent. Cả hai là case study do nhà cung cấp chọn, nên hãy kỳ vọng kết quả thấp hơn.
- Tôi chưa chạy bản dubbing, lần chuyển giọng nói thành văn bản, lần tạo nhạc hay agent triển khai thật nào, và cũng không tìm thấy mức credit mỗi ký tự của v4 trong các tài liệu tôi truy cập được. Quy tắc tải về của hiệu ứng âm thanh tự tạo trên gói miễn phí cũng chưa được thử.
Tuần đầu với gói miễn phí
Bạn có thể tạo tài khoản ElevenLabs miễn phí tại đây. Hãy tiêu 10.000 credit theo thứ tự này. Ngày một: một kịch bản thử 150 ký tự trong Text to Speech với hai tag, rồi một hiệu ứng âm thanh có thời lượng cụ thể. Ngày hai: một bản mô tả Voice Design cho người dẫn của kênh. Ngày ba: xem trước phần cài đặt dubbing và đọc dòng chi phí trước khi gửi. Sau đó, hãy cân nhắc xem gói Starter giá $6 với 30.000 credit và giấy phép thương mại có hợp với nhịp đăng bài của bạn hay không.
Tài Liệu Tham Khảo
- Tài liệu và trang giá của ElevenLabs - model, ngôn ngữ, giới hạn ký tự, dubbing, Scribe, ElevenAgents, bảng giá, chính sách sử dụng.
- Unite.AI về lần ra mắt v4 - bài đưa tin độc lập về v4.