
Các Mô Hình AI Hàng Đầu Tháng 09/2026: Năng Lực, Benchmark và Chi Phí Thực Tế
Bóc tách thực tế giữa Claude Fable 5.1, GPT-6 Astra, Gemini 3.8 Flash và DeepSeek V4.1-Flash qua benchmark chuẩn hóa, khả năng tương tác hệ điều hành và bài toán chi phí API khi chạy Agent.
Bốn model hàng đầu ra mắt từ ngày 01 đến 10/09/2026: Claude Fable 5.1, GPT-6 Astra, Gemini 3.8 Flash và DeepSeek V4.1-Flash. Điểm benchmark của hãng thường cao hơn thực tế production, nên hãy so sánh theo tỷ lệ lỗi lệnh shell và chi phí suy luận có cache.
Các hãng thường công bố điểm benchmark rất cao nhờ dựng thêm hệ thống agent bọc ngoài để trợ lực. Khi đưa vào production thực tế, bạn cần nhìn vào ba yếu tố: điểm benchmark trên môi trường chuẩn hóa độc lập, độ ổn định khi gõ lệnh terminal, và chi phí đọc cache qua các vòng lặp agent.

1. Bốn Model Mới Tháng 09/2026
Mỗi lab tối ưu cho một vai trò vận hành riêng:
| Mô hình | Nhà phát triển | Ngày công bố | Trọng tâm kiến trúc |
|---|---|---|---|
| Claude Fable 5.1 | Anthropic | 01/09/2026 | Adaptive thinking |
| GPT-6 Astra | OpenAI | 03/09/2026 | Operator & reasoning |
| Gemini 3.8 Flash | Google DeepMind | 02/09/2026 | High-throughput multi |
| DeepSeek V4.1-Flash | DeepSeek AI | 10/09/2026 | Causal Encoder-Decoder |
Claude Fable 5.1
Anthropic mở màn với Claude Fable 5.1 ngày 01/09/2026, kèm bản kiểm duyệt Claude Mythos 5.1 cho nghiên cứu an ninh mạng và sinh học. Fable 5.1 tự cân đối độ sâu suy tưởng theo độ khó bài toán. Model hỗ trợ context 1 triệu tokens và giảm giá đọc cache (prompt cache read) xuống còn $0.25/MTok.
GPT-6 Astra
OpenAI ra mắt GPT-6 Astra ngày 03/09/2026, rollout từ tài khoản trả phí sang API. Astra được huấn luyện làm operator: thao tác với giao diện máy tính, chạy lệnh terminal và giải quyết vấn đề tương tác. Context đạt 1.050.000 tokens, xếp nhãn an toàn Critical theo Khung Chuẩn Bị của OpenAI.
Gemini 3.8 Flash
Google DeepMind ra mắt Gemini 3.8 Flash cùng bản Gemini 3.8 Flash Cyber ngày 02/09/2026. Xây dựng trên nền tảng 3.7, model xử lý đồng thời văn bản, âm thanh, ảnh và video trong context 1 triệu tokens. Google tối ưu Flash cho pipeline gọi tool tần suất cao, ưu tiên thông lượng và độ trễ thấp.
DeepSeek V4.1-Flash
DeepSeek công bố V4.1-Flash ngày 10/09/2026 với kiến trúc Causal Encoder-Decoder (CED) trên nền Mixture-of-Experts 552 tỷ tham số. Model kích hoạt 8 tỷ tham số lúc nạp input và 16 tỷ tham số khi sinh output, giúp nén bộ nhớ KV-cache và giảm chi phí suy luận ngữ cảnh dài.
2. Benchmark: Điểm Thật vs Điểm "Độ"
Đánh giá AI năm 2026 đòi hỏi nhìn vào harness thử nghiệm. Các hãng thường trộn lẫn kết quả từ agent scaffold riêng với benchmark độc lập.
| Benchmark | Claude Fable 5.1 | GPT-6 Astra | Gemini 3.8 Flash | DeepSeek V4.1-Flash | Bản chất phương pháp luận |
|---|---|---|---|---|---|
| ARC-AGI-3 (Standard) | Không có điểm comparable | 62.7% | Chưa có điểm snapshot | Chưa có điểm snapshot | Chuẩn độc lập của ARC Prize Foundation |
| ARC-AGI-3 (Provider Adapter) | Không có điểm comparable | 99.9% | Chưa có điểm snapshot | Chưa có điểm snapshot | Harness riêng có scaffolding của OpenAI |
| DeepSWE v1.1 | 67.4% | 74.1% | 73.8% | 73.2% | Bài toán sửa lỗi GitHub quy mô lớn |
| Terminal-Bench 4.0 | 55.8% | 57.9% | 19.1% | Chưa có số liệu | Đo toàn bộ hệ thống agent chạy bash Linux |
| ExploitBench | Bản Mythos riêng | 100.0% | Chưa có số liệu | Chưa có số liệu | Khai thác lỗ hổng trong sandbox |
| ExploitGym | Bản Mythos riêng | 42.4% | Chưa có số kiểm chứng | Chưa có số liệu | Tác vụ phòng thủ mạng đa bước phức tạp |
ARC-AGI-3
GPT-6 Astra đạt 99.9% trên ARC-AGI-3 trong Provider Adapter Harness riêng của OpenAI. Harness này hỗ trợ tìm kiếm cây lời giải, tự sinh test xác minh và quản lý trạng thái.
Trên Standard Harness nguyên bản của ARC Prize Foundation, Astra đạt 62.7%. Con số 99.9% phản ánh năng lực của hệ thống agent trợ lực bên ngoài (scaffolding), không phải khả năng suy luận độc lập của bản thân model. Khi thiết kế hệ thống, hãy căn cứ vào điểm chuẩn hóa thay vì harness của nhà cung cấp.
DeepSWE v1.1
DeepSWE v1.1 bắt model đọc repo lớn, tìm bug thực tế và tự tạo pull request sửa lỗi. Trong bảng so sánh của OpenAI, kết quả ba hãng bám đuổi sít sao:
- GPT-6 Astra: 74.1%
- Gemini 3.8 Flash: 73.8%
- DeepSeek V4.1-Flash: 73.2% (vendor claim)
- Claude Fable 5.1: 67.4%
Khoảng điểm quanh 73% cho thấy năng lực đọc code và tạo bản vá đã trở thành tiêu chuẩn chung. Khác biệt trong thực tế nằm ở cách model phản ứng khi test fail và khả năng đổi hướng xử lý.
Terminal-Bench 4.0
Terminal-Bench 4.0 đo khả năng hoàn thành tác vụ trong shell Linux. GPT-6 Astra đạt 57.9% và Claude Fable 5.1 đạt 55.8%, kiểm soát tốt đường dẫn, mã thoát tiến trình và gỡ lỗi command line.
Gemini 3.8 Flash dừng ở mức 19.1%. Google tối ưu Flash cho các lệnh gọi tool đơn lẻ và định tuyến thông lượng cao, không phục vụ quản trị dòng lệnh phức tạp.
3. Khả Năng Chạy Agent và Tự Động Hóa
Các model phân hóa rõ rệt ở cách vận hành trong vòng lặp agent tự trị.
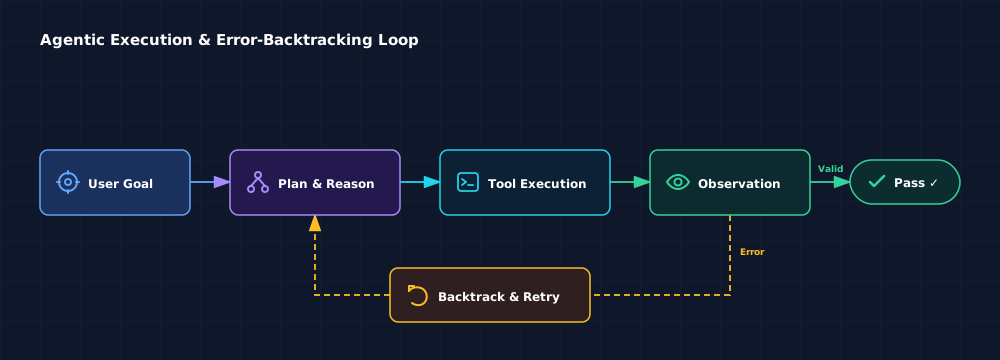
Claude Fable 5.1: Sửa Lỗi Tận Gốc
Hành vi: Khi gặp lỗi trong vòng lặp agent, Fable 5.1 truy ngược nguyên nhân: đọc git log, rà soát cây phụ thuộc và sửa file cấu hình gốc trước khi chạy lại test. Model cũng từ chối các giả định sai trong prompt thay vì sinh code theo yêu cầu lỗi.
Dùng khi: Tái cấu trúc codebase lớn nơi sửa một interface ảnh hưởng nhiều module; review kiến trúc cần chỉ rõ lỗ hổng logic; agent giữ context trên 200.000 tokens qua hàng chục bước debug liên tục.
GPT-6 Astra: Thao Tác Trực Tiếp Trên Máy Tính
Hành vi: Astra thao tác trực tiếp trên giao diện máy tính: đọc ảnh màn hình, định vị tọa độ, click duyệt web và kết hợp GUI với lệnh terminal. OpenAI xếp Astra vào mức Critical sau khi đạt 100% ExploitBench và 42.4% ExploitGym. Trên bản thương mại, OpenAI giới hạn model ở mức rà soát, kiểm toán phòng thủ và đề xuất bản vá, từ chối tạo mã khai thác thực tế.
Dùng khi: Tự động hóa thao tác trên web và phần mềm desktop; kiểm toán an ninh phòng thủ trong phạm vi cấp quyền; bài toán quy nạp quy tắc mới ngoài khuôn mẫu lập trình phổ biến.
Gemini 3.8 Flash: Xử Lý Đa Phương Thức Tốc Độ Cao
Hành vi: Gemini 3.8 Flash nạp trực tiếp video quay màn hình, file ghi âm trao đổi kỹ thuật và tài liệu vào context window cùng mã nguồn. Trong vòng lặp tự trị, model hay kết luận sớm sau một lần gọi tool nếu prompt không yêu cầu kiểm tra lại.
Dùng khi: Phân tích tài liệu đa phương thức gồm video, âm thanh và văn bản; làm tầng tiền tiêu định tuyến request cho các model chuyên sâu; truy vấn kho dữ liệu tĩnh qua Context Caching ở mức $0.075/MTok.
DeepSeek V4.1-Flash: Tối Ưu Context Dài Với Chi Phí Thấp
Hành vi: Cấu trúc Causal Encoder-Decoder tách rời nạp input và sinh output, kích hoạt 8 tỷ tham số lúc đọc dữ liệu. Model duy trì tốc độ sinh token ổn định kể cả khi lịch sử vượt 500.000 tokens, tránh tràn bộ nhớ GPU qua các phiên làm việc kéo dài.
Dùng khi: Pipeline xử lý dữ liệu hàng loạt (lint code, sinh unit test, tái cấu trúc file); tác vụ nhạy cảm về chi phí cần giá sàn thấp; endpoint tương thích OpenAI ưu tiên thông lượng thay vì điều khiển GUI.
4. Tối Ưu Chi Phí API Bằng Caching
Chuyển từ chatbot sang agent tự trị làm thay đổi bài toán chi phí API. Nhìn vào đơn giá triệu token niêm yết không phản ánh đúng hóa đơn vận hành thực tế.
| Nhà cung cấp | Mô hình | Giá Input Thường | Giá Đọc Cache / Context Caching | Giá Output | Cơ chế Caching |
|---|---|---|---|---|---|
| Anthropic | Claude Fable 5.1 | $10.00 / MTok | $0.25 / MTok | $50.00 / MTok | Prompt Cache tức thì (giảm 75% so với Fable 5) |
| OpenAI | GPT-6 Astra | $10.00 / MTok | $1.00 / MTok | $50.00 / MTok | Giảm giá tiền tố Cached Input |
| Gemini 3.8 Flash | $0.75 / MTok | $0.075 / MTok | $3.75 / MTok | Context Caching lưu server (thu phí theo giờ) | |
| DeepSeek | DeepSeek V4.1-Flash | $0.30 / MTok | $0.06 / MTok | $1.20 / MTok | Giảm giá Cache Read khớp tiền tố prompt |
Cơ Chế Caching
- Prompt Caching Tức Thì (Anthropic và DeepSeek): Khi các lượt gọi API liên tiếp gửi lại cùng phần tiền tố (system prompt, định nghĩa tool, lịch sử chat), máy chủ bỏ qua tính toán lại attention state. Anthropic giảm 97.5% giá đọc cache ($0.25 so với $10.00). DeepSeek giảm 80% ($0.06 so với $0.30).
- Context Caching Chủ Động (Google): Google cho phép lưu hẳn tài liệu lớn hoặc video lên RAM máy chủ. Mỗi truy vấn tham chiếu vào kho này chỉ tốn $0.075/MTok, cộng thêm phí lưu trữ theo giờ.
Chi Phí Thực Tế Cho Mỗi Task
Xét ví dụ một agent refactor module phần mềm:
- Context cố định: 150.000 tokens (repository, schema, test suite).
- Quy trình: 20 lượt gọi tool tuần tự (đọc code, chạy thử, sửa lỗi, kiểm tra lại).
Nếu tính kiểu cũ không caching, 20 lượt gọi gửi lại 150.000 tokens tương đương 3 triệu tokens input ($30.00 với model $10/MTok).
Khi tận dụng Prompt Caching:
- Lần gọi đầu (Cold input): 150.000 tokens * $10.00/MTok = $1.50
- 19 lần tiếp theo (Cache hit): 19 * 150.000 tokens * $0.25/MTok = $0.71
- Tổng chi phí input chỉ còn $2.21, giảm hơn 92%.
Mức giá cache read $0.25/MTok biến Claude Fable 5.1 thành lựa chọn kinh tế trong chu trình agent phức tạp. DeepSeek V4.1-Flash có đơn giá sàn thấp nhất trong 4 model, tối ưu cho các pipeline chạy nền quy mô lớn.
5. Đúc Kết Lại
- Dựa vào benchmark tiêu chuẩn: Điểm 62.7% trên ARC-AGI-3 chuẩn phản ánh đúng năng lực suy luận của Astra; 99.9% là kết quả khi có hệ thống agent bọc ngoài trợ lực.
- Năng lực code đã hội tụ: Điểm DeepSWE v1.1 của bốn lab đều quanh 67% đến 74%. Tiêu chí chọn model chuyển sang độ ổn định shell và khả năng tự sửa lỗi.
- Môi trường dòng lệnh tạo ranh giới: GPT-6 Astra (57.9%) và Claude Fable 5.1 (55.8%) làm chủ shell Linux. Gemini 3.8 Flash (19.1%) phù hợp luồng công việc có cấu trúc sẵn.
- Chi phí đọc cache quyết định hóa đơn: Giá đọc cache $0.25/MTok của Claude Fable 5.1 giúp các chu trình agent lặp nhiều bước rẻ hơn model tầm trung không cache.
- Chọn model theo bài toán: Fable 5.1 cho debug sâu, Astra cho tự động hóa GUI và desktop, Gemini cho định tuyến đa phương thức, DeepSeek cho pipeline xử lý hàng loạt.
Tài Liệu Tham Khảo
- Anthropic. "Claude Fable and Mythos 5.1 Announcement." Tháng 09/2026. https://www.anthropic.com/claude-fable-and-mythos-5-1
- OpenAI. "GPT-6 Astra: Next-Generation Frontier Model." Tháng 09/2026. https://openai.com/index/gpt-6-astra/
- OpenAI Developers. "GPT-6 Astra API Model Documentation." Tháng 09/2026. https://developers.openai.com/api/docs/models/gpt-6-astra
- Google DeepMind. "Gemini 3.8 Flash and Flash Cyber Announcement & Model Card." Tháng 09/2026. https://blog.google/innovation-and-ai/models-and-research/gemini-models/3-8-flash-and-3-8-flash-cyber/
- DeepSeek AI. "DeepSeek V4.1-Flash Announcement and Specifications." Tháng 09/2026. https://www.deepseek.com/en/news/deepseek-v4-1-flash/
- ARC Prize Foundation. "OpenAI GPT-6 Astra ARC-AGI-3 Verified Evaluation." Tháng 09/2026. https://arcprize.org/results/openai-gpt-6-astra
- DeepSWE Research Team. "DeepSWE: Benchmarking Real-World Software Engineering at Scale." arXiv:2607.07946, 2026. https://arxiv.org/abs/2607.07946
- Google Cloud. "Gemini API Pricing Documentation." Tháng 09/2026. https://ai.google.dev/gemini-api/docs/pricing?authuser=3

