Codex vs Claude Code năm 2026: Nên dùng AI coding agent nào?
So sánh Codex và Claude Code qua điểm Terminal-Bench 4.0 từ tbench.ai, chi phí mỗi lượt chạy, số liệu người dùng và những nhận xét thẳng về chỗ dữ liệu còn yếu.
Tóm lại: Chưa có bên nào thắng hẳn. Trên Terminal-Bench 4.0, phiên bản mới nhất của benchmark độc lập này, Claude Code chạy Opus 5.5 giải đúng 64,8% số bài, còn Codex chạy GPT-6.1 Sol giải đúng 58,2%. Mức cao hơn 6,6 điểm phần trăm đó vừa nằm ngoài sai số, và đợt chạy của Claude Code tốn khoảng $4,7k so với khoảng $0,6k của Codex, tức gấp chừng 8 lần. Việc khó mà bạn cần làm đúng ngay lần đầu thì nghiêng về Claude Code. Cần tiết kiệm chi phí thì nghiêng về Codex. Cách chắc ăn nhất là chạy thử cả hai trên chính repo của bạn.
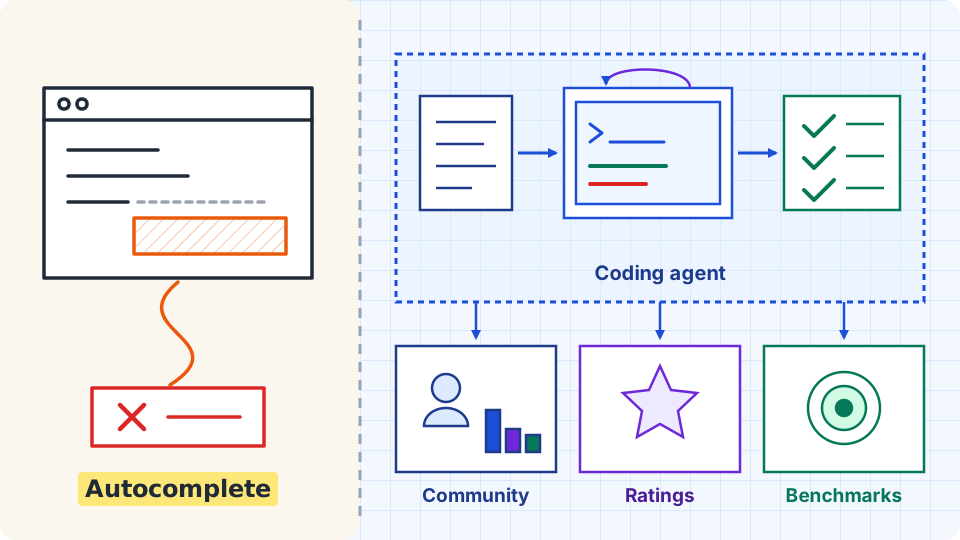
Codex và Claude Code là hai AI coding agent bị đem ra so sánh nhiều nhất trong năm 2026. Cả hai đều là công cụ coding agentic: đọc được codebase, sửa file, chạy lệnh và mở pull request. Điểm khác nằm ở chỗ công việc được thực hiện ở đâu, và mỗi lần làm hỏng thì bạn mất bao nhiêu.
Codex và Claude Code là gì?
Codex là coding agent của OpenAI. CLI của nó là một agent terminal mã nguồn mở theo giấy phép Apache 2.0 (GitHub), và Codex còn chạy dưới dạng extension cho IDE, app desktop và tác vụ cloud nằm trong các sandbox riêng. Trang giá API của OpenAI hiện liệt kê GPT-6.1 Sol và GPT-6.1 Terra là các model GPT-6.1 hiện tại (OpenAI).
Claude Code là coding agent của Anthropic. Bạn dùng được nó trong terminal, IDE, app desktop, web và Slack, và nó làm việc ngay trên môi trường máy của bạn. Các model hiện nay của Anthropic là Opus 5.5, Sonnet 5.5, Fable 5.1 và Haiku 5.5 (Anthropic). CLI của Claude Code là mã nguồn đóng.
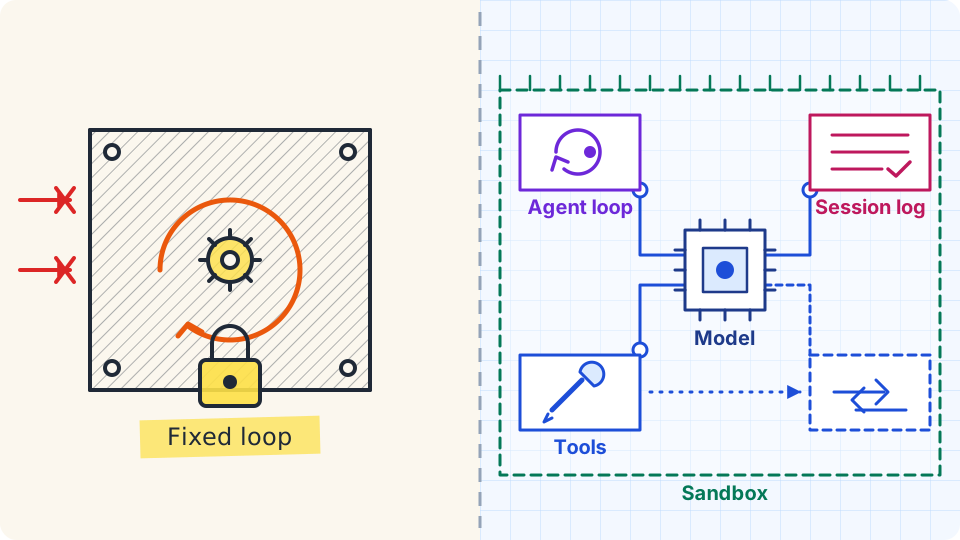
Điểm benchmark là điểm của cả bộ ba agent, model và mức effort, không phải của riêng bên nào. Bảng Terminal-Bench liệt kê từng dòng theo cách đó, ví dụ "Opus 5.5 (max)" chạy với Claude Code. Đổi agent hoặc đổi effort là điểm đổi theo, nên gán công cho "Claude" hay "Codex" nói chung là chưa chặt chẽ.
Benchmark: bên nào điểm cao hơn?
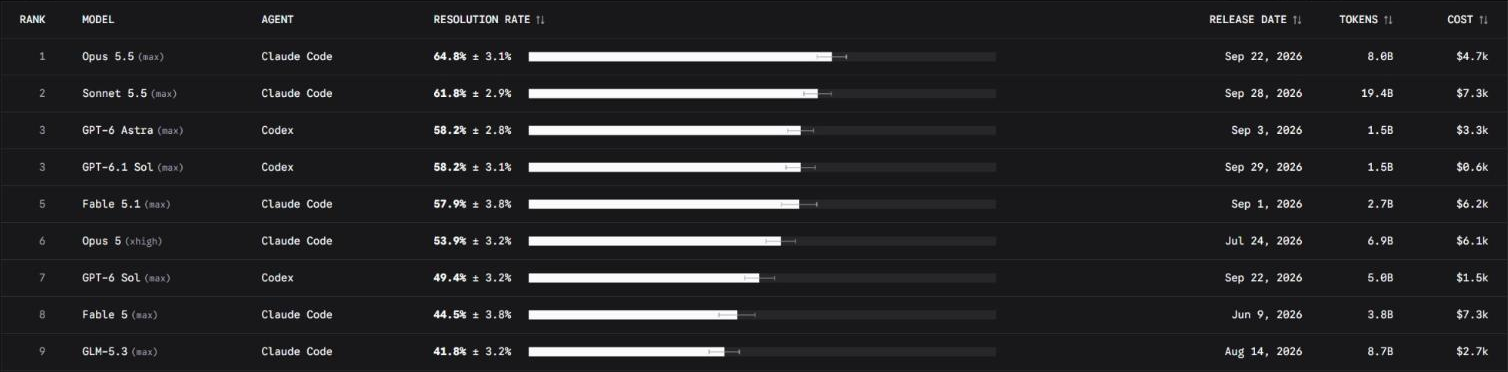
Claude Code dẫn đầu trên benchmark mới nhất, và khoảng cách ở mức vừa phải.
Terminal-Bench là benchmark gồm các tác vụ lập trình qua terminal, do Stanford, Harbor và Laude Institute đứng ra tổ chức. Bảng xếp hạng của nó giữ nhiều phiên bản, và mới nhất là 4.0.
| Mục (agent + model) | Tỷ lệ giải đúng | Token | Chi phí cả đợt |
|---|---|---|---|
| Claude Code + Opus 5.5 (max) | 64,8% ± 3,1 | 8,0B | $4,7k |
| Claude Code + Sonnet 5.5 (max) | 61,8% ± 2,9 | 19,4B | $7,3k |
| Codex + GPT-6.1 Sol (max) | 58,2% ± 3,1 | 1,5B | $0,6k |
| Codex + GPT-6 Astra (max) | 58,2% ± 2,8 | 1,5B | $3,3k |
| Claude Code + Fable 5.1 (max) | 57,9% ± 3,8 | 2,7B | $6,2k |
Nguồn: tbench.ai. Phần ± là khoảng tin cậy 95%.
Claude Code giữ hai vị trí đầu. Opus 5.5 và GPT-6.1 Sol là model mặc định hiện nay của mỗi công cụ, và khoảng tin cậy của chúng (khoảng 61,7–67,9 so với 55,1–61,3) vừa đủ không chồng lên nhau, nên mức cao hơn này là có thật nhưng nhỏ. Các mục tốt nhất của Codex ngang với Fable 5.1 của Claude Code.
Mức effort cũng làm kết quả khác đi. Tài liệu của Anthropic ghi effort mặc định của Opus 5.5 trên API là medium (Anthropic), trong khi dòng trên bảng xếp hạng chạy ở mức max. Khi dùng thật, bạn có thể thấy kết quả thấp hơn bảng xếp hạng.
Dù vậy, tôi chỉ coi bảng này là chỉ hướng chứ không phải phán quyết. Bảng benchmark đổi rất nhanh, chính trang này vẫn giữ phiên bản 2.1 cũ với thứ hạng khác, nên một con số trích mà thiếu phiên bản và ngày đọc rất dễ sai. Cột chi phí chỉ có tổng cả đợt đã làm tròn đến $0,1k và không có số lượt chạy, nên không thể đổi nó thành giá mỗi tác vụ. Bảng xếp hạng cũng không nói gì về ngôn ngữ lập trình, quy mô repo hay thói quen review của bạn, mà những thứ này nhiều khả năng quyết định kết quả hơn.
Chi phí: Codex hay Claude Code rẻ hơn?
Tính theo cả đợt chạy, Codex rẻ hơn rất nhiều. Tính theo chi phí cho mỗi 1% task được giải quyết, Codex vẫn rẻ hơn rất nhiều.
Trên cùng các tác vụ benchmark, đợt chạy của Claude Code tốn gấp khoảng 8 lần đợt của Codex, đổi lại giải quyết được nhiều hơn 6,6 điểm phần trăm. Cột cuối trong bảng là phép tính riêng của bài này, dựa trên số liệu của bảng xếp hạng.
| Tỷ lệ giải đúng | Token | Chi phí cả đợt | Chi phí cho mỗi 1% task được giải quyết (tự tính) | |
|---|---|---|---|---|
| Claude Code + Opus 5.5 | 64,8% | 8,0B | $4,7k | khoảng $73 |
| Codex + GPT-6.1 Sol | 58,2% | 1,5B | $0,6k | khoảng $10 |
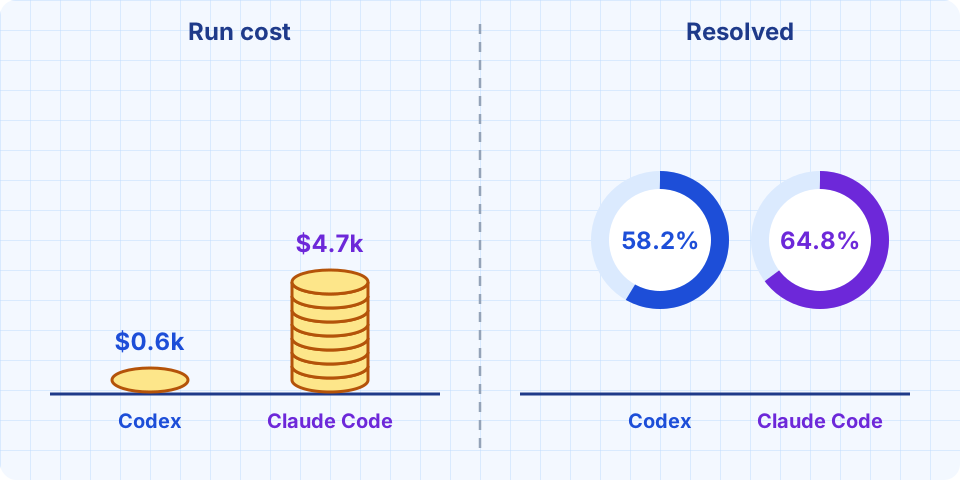
Mỗi 1% task được giải quyết với Claude Code đắt hơn khoảng 7 lần. Khoản chênh lệch đó có đáng hay không còn tùy một lần làm hỏng tốn của bạn bao nhiêu. Nếu mỗi lần hỏng đồng nghĩa với một vòng review của kỹ sư senior, thì độ chính xác lại có thể là lựa chọn rẻ hơn.
Tôi sẽ không dựa nhiều vào cột tính thêm. Nó giả định tổng chi phí tăng theo tỷ lệ giải đúng, mà lượt thất bại có thể tốn nhiều hơn hoặc ít hơn lượt thành công. Con số $0,6k đã được làm tròn, nên tỷ lệ thật có thể nằm trong khoảng 7 đến 9 lần. Nó cho thấy bậc độ lớn, không phải mức giá.
Giá niêm yết chỉ giải thích được một phần khoảng cách. Opus 5.5 tính $4 cho mỗi triệu token đầu vào và $20 cho đầu ra, còn GPT-6.1 Sol là $2 và $10 (Anthropic, OpenAI). Chênh nhau hai lần, trong khi đợt chạy của Claude Code dùng gấp khoảng 5 lần lượng token, 8,0 tỷ so với 1,5 tỷ. Lượng token thậm chí còn lấn át giá: Sonnet 5.5 niêm yết $2 và $10 mỗi triệu, bằng một nửa Opus 5.5, vậy mà đợt chạy của nó đốt 19,4 tỷ token và tốn $7,3k, so với $4,7k của Opus 5.5.
Về gói đăng ký: Claude Code đi kèm Claude Pro ($20/tháng) hoặc Max ($100 và $200). Codex đi kèm các gói ChatGPT, trong đó có Plus ($20). Cả hai hiện đều tính hạn mức theo khung 5 giờ, có trần theo tuần và cho mua thêm credit. Dù vậy, nhiều người dùng vẫn nói rằng ở mức $20 thì Codex dùng được lâu hơn. Đây là phản hồi của người dùng chứ không phải thông số chính thức.
Bao nhiêu lập trình viên đang dùng mỗi công cụ?
Trong khảo sát lập trình viên duy nhất hiện có, Claude Code dẫn đầu về mức độ yêu thích. Codex thì báo cáo đà tăng rất dốc, dù xuất phát từ nền thấp hơn. Các con số dưới đây đo những thứ khác nhau, nên đừng đem chúng ra trừ nhau.
- Khảo sát của The Pragmatic Engineer với 906 kỹ sư (27/1–17/2/2026): 46% chọn Claude Code là công cụ yêu thích nhất, Cursor 19%, GitHub Copilot 9%. 70% người được hỏi dùng 2–4 công cụ AI cùng lúc, và mức sử dụng Codex bằng khoảng 60% của Cursor (Pragmatic Engineer).
- Anthropic cho biết doanh thu quy năm của Claude Code vượt 2,5 tỷ USD vào tháng 2/2026. Số người dùng hoạt động hằng tuần đã tăng gấp đôi kể từ 1/1, và khách hàng doanh nghiệp đóng góp hơn nửa doanh thu (Anthropic).
- OpenAI cho biết ngày 2/6/2026 Codex có hơn 5 triệu người dùng hoạt động hằng tuần, tăng hơn 6 lần kể từ khi app desktop ra mắt hồi tháng 2 (OpenAI).
Có vài điều cần lưu ý khi đọc cả ba con số này. Khảo sát diễn ra đầu năm 2026 trong nhóm độc giả bản tin tự chọn trả lời, trước vài thế hệ model và trước đợt Codex tăng mạnh nhất, và nó không công bố tỷ lệ "yêu thích nhất" của Codex. Người dùng hoạt động hằng tuần và doanh thu quy năm đều do công ty tự công bố, chưa ai kiểm toán, và đo những chuyện khác nhau.
Cách làm việc hằng ngày khác nhau ra sao?
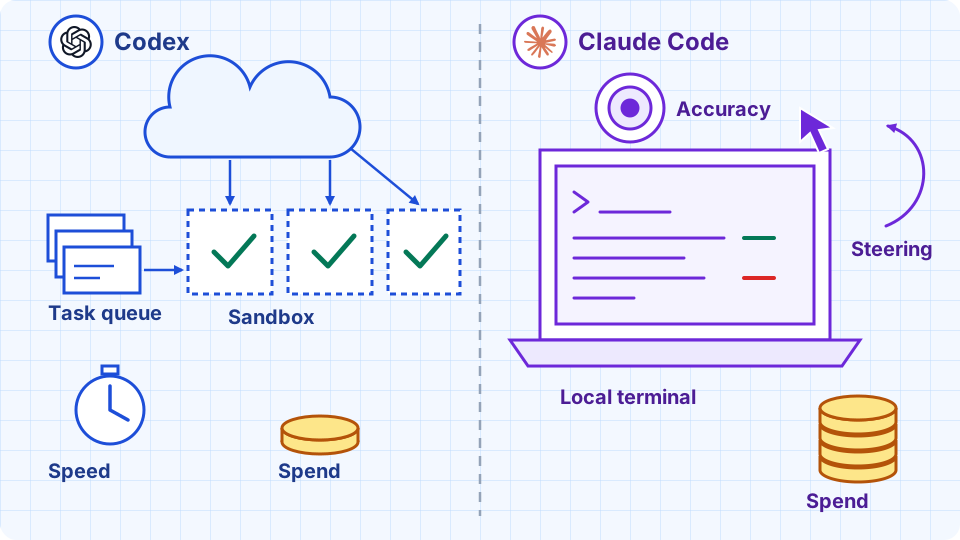
Khác biệt đầu tiên là nơi code được chạy. Codex có thể giao tác vụ cho sandbox trên cloud (bài tổng kết OpenAI DevDay 2026 có nói về Codex Cloud), hoặc chạy ngay trên máy qua CLI. Claude Code thì làm việc trực tiếp trong môi trường của bạn, nhưng không buộc bạn phải ngồi trước terminal: lệnh /remote-control mở một phiên Remote Control để bạn theo dõi và điều khiển phiên đang chạy từ điện thoại hoặc trình duyệt, và phiên đó giữ nguyên lịch sử hội thoại hiện tại (Claude Code Docs). Điều kiện là máy của bạn phải luôn bật, vì code vẫn chạy trên máy đó. Vì vậy, nếu muốn giao việc rồi không cần bật máy của bạn, sandbox cloud của Codex hợp hơn. Nếu muốn code chạy trong môi trường của bạn mà vẫn theo dõi và chỉnh hướng từ xa, Claude Code với Remote Control cũng làm được.
Kích thước context thì không còn là điểm phân biệt. Opus 5.5 niêm yết cửa sổ 1M token (Anthropic). GPT-6.1 Sol niêm yết 1,05M trên API, dù Codex mặc định dùng 500K (OpenAI). Cửa sổ lớn vẫn có lúc đầy, nên nén context cho coding agent vẫn cần với cả hai công cụ.
CLI của Codex là mã nguồn mở theo Apache 2.0, còn Claude Code thì không. Nếu bạn cần đọc hoặc fork chính agent, đây có thể là yếu tố thay đổi quyết định của bạn. Nếu muốn thay cả vòng lặp agent, bài đánh giá DeepSeek Harness so sánh nó với cả hai.
Cả hai đều ra tính năng mới gần như mỗi tháng. Vì vậy, bảng so sánh tính năng cũ hơn một tháng thì khả năng cao là đã lỗi thời.
Nên chọn công cụ nào?
| Codex | Claude Code | |
|---|---|---|
| Hãng | OpenAI | Anthropic |
| Chạy ở đâu | CLI, IDE, app desktop, sandbox trên cloud | Terminal, IDE, app desktop, web, Slack; môi trường máy của bạn |
| Giấy phép CLI | Apache 2.0 | Mã nguồn đóng |
| Model hiện tại | GPT-6.1 Sol, GPT-6.1 Terra | Opus 5.5, Sonnet 5.5, Fable 5.1, Haiku 5.5 |
| Terminal-Bench 4.0 | 58,2% (GPT-6.1 Sol) | 64,8% (Opus 5.5) |
| Chi phí cả đợt (4.0) | khoảng $0,6k | khoảng $4,7k |
| Giá API mỗi triệu token | $2 vào, $10 ra (Sol) | $4 vào, $20 ra (Opus 5.5) |
| Gói đăng ký | Các gói ChatGPT, Plus $20 | Claude Pro $20, Max $100–$200 |
Chọn Claude Code nếu bạn hay làm những thay đổi khó trải trên nhiều file, nơi làm sai ngay lần đầu rất tốn kém, nếu bạn thích ngồi cạnh và điều khiển agent trực tiếp, hoặc nếu công ty bạn vốn đã dùng dịch vụ của Anthropic.
Chọn Codex nếu bạn chạy nhiều tác vụ song song, canh chi phí token sát sao, muốn một CLI mã nguồn mở, hoặc đã trả tiền cho ChatGPT sẵn.
Nếu được thì dùng cả hai. Phần lớn kỹ sư trong khảo sát của Pragmatic Engineer cũng đang dùng nhiều công cụ cùng lúc trong bảng xếp hạng các AI coding agent năm 2026.
Nếu phải chọn một, tôi sẽ bắt đầu với công cụ mà nhóm bạn đã trả tiền, và chỉ đổi khi một tuần chạy trên ticket của chính bạn cho thấy điều ngược lại. Kết luận ở đây sẽ đổi nếu phiên bản benchmark tiếp theo xếp lại các dòng đầu bảng hoặc nếu một trong hai hãng đổi giá, nên hãy mở lại tbench.ai trước khi dựa vào bất kỳ con số nào trong bài này.
Làm sao để tự thử cả hai trên repo của bạn?
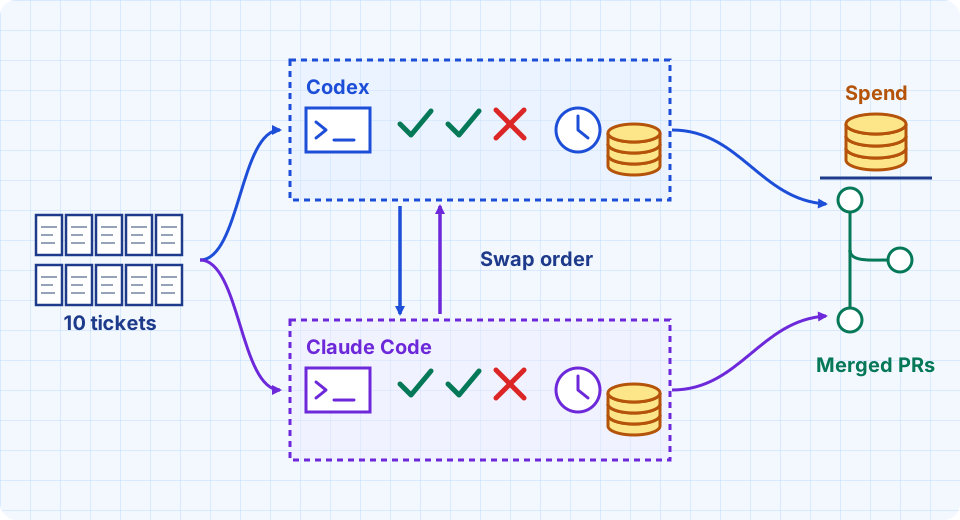
Một tuần là đủ để thấy xu hướng. Lấy mười ticket thật, độ khó trộn lẫn, rồi giao cho cả hai công cụ với cùng prompt, cùng quyền hạn và cùng bộ test. Ghi lại kết quả đạt hay không, số comment review, thời gian chạy thực tế và lượng credit đã dùng. Sang đợt thứ hai thì đổi thứ tự, để việc đã quen codebase không giúp bên chạy sau. Cuối cùng lấy tổng chi phí chia cho số pull request đã được merge. Con số này trả lời câu hỏi tốt hơn bất kỳ bảng xếp hạng nào ở trên, vì nó đã tính cả những lần thất bại của riêng bạn. Muốn chạy cả hai công cụ trên các ticket khác nhau cùng lúc, một app desktop như Orca cho mỗi agent một git worktree riêng.
Câu hỏi thường gặp
Codex có tốt hơn Claude Code không?
Chưa thể nói vậy. Trên Terminal-Bench 4.0, Claude Code chạy Opus 5.5 giải đúng nhiều bài hơn (64,8% so với 58,2%), còn đợt chạy của Codex rẻ hơn rất nhiều. Bên nào tốt hơn còn tùy một lần làm hỏng tốn của bạn bao nhiêu.
Công cụ nào rẻ hơn?
Codex. Trên Terminal-Bench 4.0, đợt chạy của nó tốn khoảng $0,6k so với khoảng $4,7k, và tính theo chi phí cho mỗi 1% task được giải quyết bằng phép chia đơn giản thì vẫn rẻ hơn khoảng 7 lần.
Dùng cả Codex và Claude Code cùng lúc được không?
Được. 70% kỹ sư trong khảo sát của Pragmatic Engineer dùng từ 2 đến 4 công cụ AI cùng lúc.
Codex có phải mã nguồn mở không?
CLI của Codex là mã nguồn mở (Apache 2.0). Claude Code thì không.
Terminal-Bench là gì?
Là bộ benchmark đo xem một AI agent có làm xong được các tác vụ lập trình thực tế bằng cách điều khiển terminal hay không: sửa file, chạy lệnh, xử lý lỗi.
Tài Liệu Tham Khảo
- Bảng xếp hạng Terminal-Bench 4.0 (tbench.ai)
- Giá API của Anthropic và tổng quan model Claude Opus 5.5
- Giá API của OpenAI và trang model GPT-6.1 Sol
- OpenAI: Codex cho công việc tri thức
- openai/codex trên GitHub
- Claude Code Docs: Remote Control
- The Pragmatic Engineer: AI tooling 2026
- Anthropic: thông báo Series G