Top AI coding agent năm 2026: Xếp hạng theo cộng đồng, đánh giá của lập trình viên và benchmark
Coding agent nào dẫn đầu tháng 11/2026? Xếp hạng Claude Code, Codex, Cursor, GitHub Copilot và OpenCode theo mức độ phổ biến trong công việc, độ hài lòng của lập trình viên và điểm benchmark.
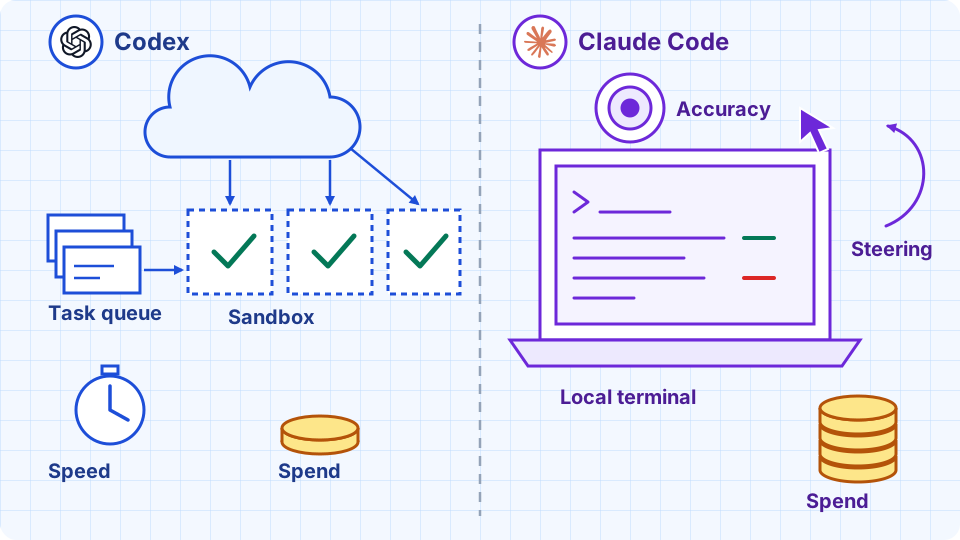
Trả lời nhanh: Đến tháng 11/2026, chưa coding agent nào thắng ở mọi tiêu chí. Claude Code hiện là agent được dùng nhiều nhất nơi làm việc (39%, 47% tại Mỹ), dẫn đầu độ hài lòng (CSAT 91%) và đứng nhất Terminal-Bench 4.0 (64,8%). GitHub Copilot vẫn là mặc định ở doanh nghiệp với 21% tỷ lệ dùng và độ nhận biết rộng nhất, còn Codex của OpenAI tăng gấp năm lần lên 16% và xếp thứ ba trên benchmark này (58,2%) với chi phí chạy bằng khoảng một phần tám. Cursor giảm còn 12% tỷ lệ dùng nhưng vẫn có doanh thu quy năm vượt 4 tỷ USD, còn OpenCode dẫn đầu nhóm mã nguồn mở về số sao GitHub.
Mốc dữ liệu: khảo sát AI Pulse của JetBrains thu thập tháng 1/2026; khảo sát Hệ sinh thái Lập trình viên thu thập từ tháng 5 đến tháng 7/2026. Stack Overflow thu thập từ 23/6 đến 5/8/2026. The Pragmatic Engineer khảo sát 906 người đăng ký từ 27/1 đến 17/2/2026. Terminal-Bench 4.0 phát hành ngày 28/8/2026, và SWE-Bench Pro V2 phát hành ngày 22/9/2026. Số sao GitHub là ảnh chụp ngày 8/11/2026; lượt tải npm tính trong 30 ngày đến 6/11/2026.
AI coding agent là gì?
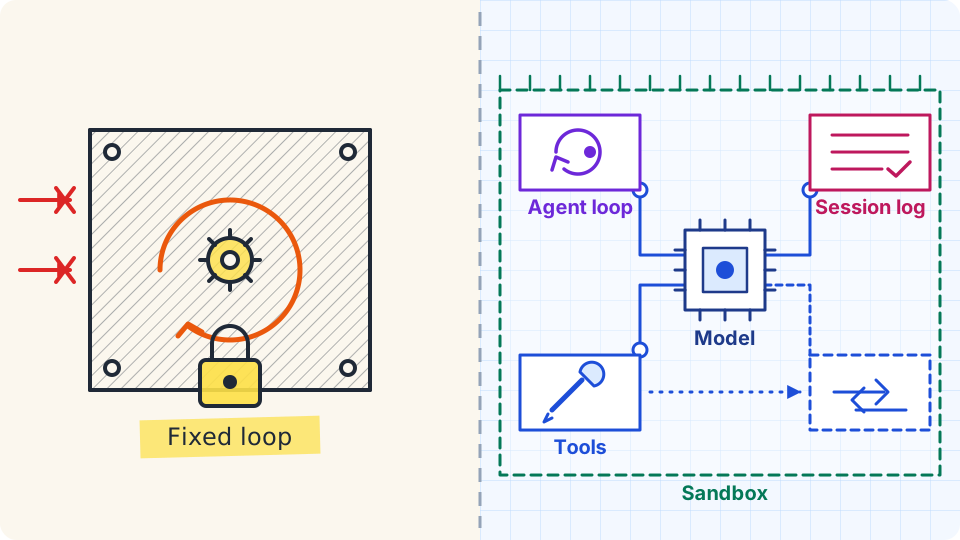
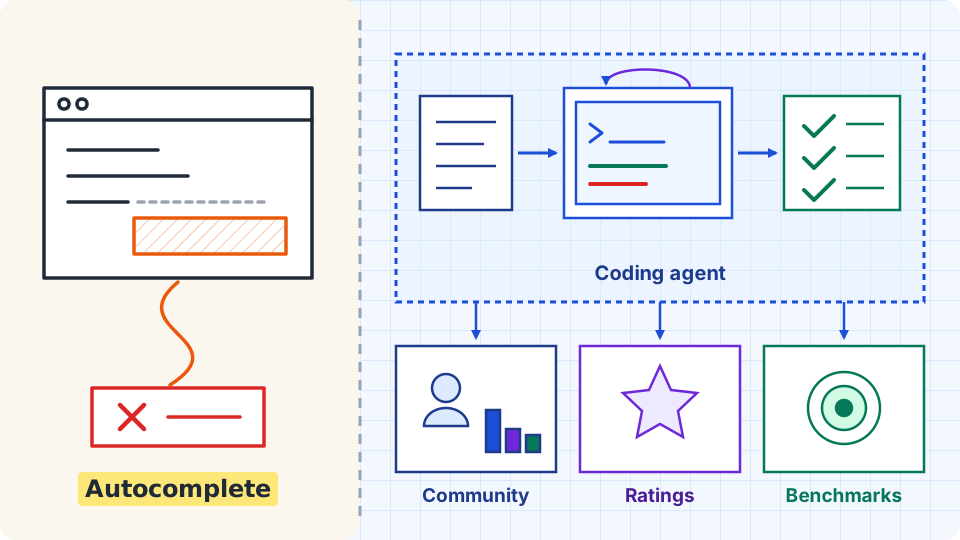
AI coding agent nhận task bằng ngôn ngữ tự nhiên, đọc repo, sửa file, chạy lệnh terminal cùng test, rồi lặp lại đến khi pass. Autocomplete chỉ gợi ý dòng kế tiếp, còn quy trình agentic engineering hoàn thành trọn ticket. Trong khảo sát năm 2026 của Stack Overflow, 66% người dùng AI làm việc với coding agent, gần ngang mức 63% dùng chatbot. Muốn chạy nhiều agent song song, xem bài review Orca Agent IDE.
Cách xếp hạng trong bài
Đánh giá coding agent cần ba góc tách biệt: cộng đồng, đánh giá của lập trình viên và điểm benchmark. Vì ba góc này đo các khía cạnh khác nhau, gộp chúng vào một điểm chung sẽ làm mờ sự khác biệt. Khi thiếu dữ liệu tương đương, ô thông tin để trống.
Góc 1: Coding agent nào có cộng đồng lớn nhất?
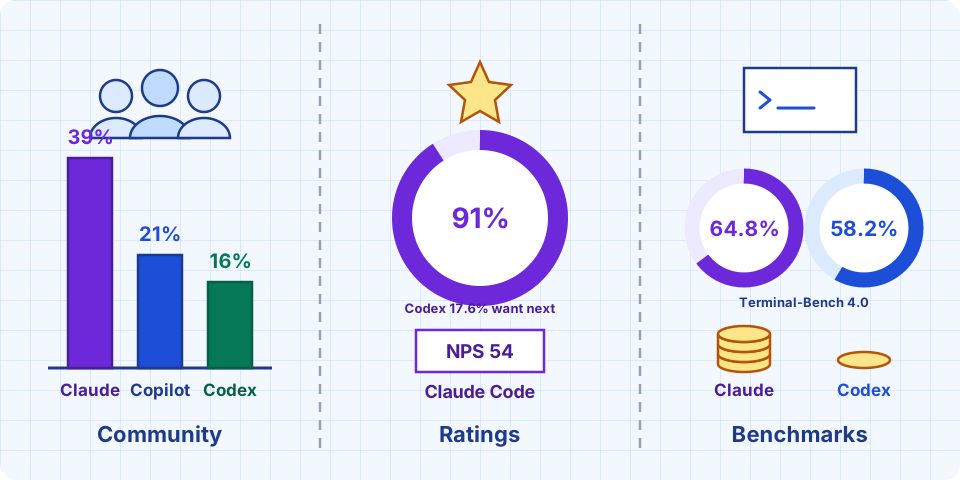
Khảo sát mức sử dụng tại nơi làm việc ổn định hơn số sao GitHub, vốn phản ánh việc đánh dấu repo hơn là tần suất dùng hằng ngày. Mẫu khảo sát mức dùng tại nơi làm việc mới nhất là Khảo sát Hệ sinh thái Lập trình viên 2026 của JetBrains, thu thập từ tháng 5 đến tháng 7/2026 và công bố tháng 8, trên hơn 15.000 lập trình viên chuyên nghiệp: 90% dùng AI coding agent tại nơi làm việc ít nhất hằng tuần và 68% dùng hằng ngày. Tỷ lệ dùng cho công việc đạt 39% với Claude Code (47% tại Mỹ), 21% với GitHub Copilot, 16% với OpenAI Codex, 12% với Cursor, 9% với JetBrains AI, 7% với OpenCode và 6% với Google Antigravity. Claude Code cũng là công cụ chính của 31% lập trình viên, tức tỷ lệ chuyển đổi gần 80% từ người dùng thường xuyên.
Khảo sát Stack Overflow năm 2026, thu thập từ 23/6 đến 5/8/2026 và công bố ngày 6/10, đo mức lựa chọn trong nhóm dùng coding agent: Claude Code (65,5%) và GitHub Copilot (58,7%) dẫn đầu, tiếp theo là Codex (29,5%) và Cursor (25,5%); 73% người dùng coding assistant hoặc agent chạy chúng mỗi ngày.
Top 5 theo cộng đồng
- Claude Code. Dẫn đầu rõ rệt tại nơi làm việc: 39% toàn cầu, 47% tại Mỹ và 65,5% trong nhóm người dùng agent của Stack Overflow. Trong thông báo Series G, Anthropic cho biết doanh thu quy năm của Claude Code vượt 2,5 tỷ USD tháng 2/2026 (từ 1 tỷ USD tháng 11/2025).
- GitHub Copilot. Đây vẫn là mặc định ở doanh nghiệp. Tỷ lệ dùng đạt 40% tại công ty trên 5.000 nhân sự trong đợt tháng 1/2026, và độ nhận biết toàn cầu là 79%, nhưng tỷ lệ dùng cho công việc giảm từ 29% xuống 21% trong một năm.
- OpenAI Codex. Tỷ lệ dùng tăng gấp năm lần từ 3% tháng 1/2026 lên 16% vào tháng 5 đến tháng 7, độ nhận biết tăng từ 27% lên 65%. OpenAI công bố hơn 5 triệu người dùng/tuần ngày 2/6/2026, với ~20% ngoài khối kỹ thuật (số liệu hãng công bố). CLI Apache 2.0 (openai/codex) đạt 133.600 sao GitHub (ảnh chụp 8/11/2026) và 95,6 triệu lượt tải npm trong 30 ngày tính đến 6/11/2026, vượt mức 47,4 triệu của Claude Code.
- Cursor. Tỷ lệ dùng cho công việc giảm từ 18% tháng 1 xuống 12% vào tháng 5 đến tháng 7, và đứng thứ tư trong nhóm người dùng agent của Stack Overflow (25,5%). Doanh thu quy năm đạt 2 tỷ USD tháng 2 và vượt 4 tỷ USD tháng 6 (~75% doanh nghiệp).
- OpenCode. Agent mã nguồn mở MIT (sst/opencode) hỗ trợ 75+ nhà cung cấp model và đạt 225.200 sao GitHub (ảnh chụp 8/11/2026), cao nhất trong các repo coding agent. Công cụ này đạt 7% tỷ lệ dùng tại nơi làm việc.
Đáng chú ý khác: Gemini CLI (108.800 sao, Apache 2.0), Cline (71.400 sao) và Aider (50.000 sao), đều là ảnh chụp ngày 8/11/2026. Repo anthropics/claude-code (154.900 sao) chỉ chứa tài liệu và issue tracker, nên đừng so trực tiếp số sao với OpenCode hay Codex CLI.
Góc 2: Lập trình viên đánh giá coding agent nào cao nhất?
Không có bài công bố nào chấm điểm mọi agent trên cùng một thang. JetBrains là khảo sát lớn duy nhất công bố điểm gắn bó kiểu CSAT/NPS theo từng công cụ, và dữ liệu AI Pulse tháng 1/2026 (công bố tháng 4) cho Claude Code CSAT 91% cùng NPS 54, mức mà JetBrains mô tả là cao nhất thị trường. Bài công bố chỉ nêu điểm của Claude Code và không có CSAT/NPS tương đương cho Copilot, Cursor hay Codex. Vì vậy, hãy hiểu "cao nhất" là kết luận của JetBrains, không phải một bảng điểm đầy đủ.
Hai thước đo còn lại nói về sở thích, không phải độ hài lòng. Trong khảo sát của The Pragmatic Engineer, thu thập từ 27/1 đến 17/2/2026 và công bố ngày 3/3, người trả lời chọn công cụ yêu thích nhất: Claude Code 46%, Cursor 19%, GitHub Copilot 9%, OpenAI Codex khoảng 8% và OpenCode khoảng 7%. Bài công bố chỉ nêu số chính xác cho ba công cụ đầu. Hai số còn lại đọc từ biểu đồ của khảo sát. Khảo sát Stack Overflow 2026, thu thập từ 23/6 đến 5/8/2026, hỏi một câu khác: agent nào họ muốn dùng trong sáu tháng tới. Thứ tự ở đây đảo lại: Claude Code 41,4%, GitHub Copilot 19,6%, OpenAI Codex 17,6%, rồi Cursor (11,7%) và OpenCode (11,7%). Mẫu của The Pragmatic Engineer nghiêng về người có thâm niên và dùng terminal. Trung vị là 11 đến 15 năm kinh nghiệm, và 34% thuộc ban lãnh đạo kỹ thuật, nên khảo sát đo mức yêu thích của kỹ sư giàu kinh nghiệm, không phải lập trình viên trung bình.
Top 5 theo đánh giá (xếp theo "yêu thích nhất")
- Claude Code. Dẫn đầu cả hai khảo sát sở thích (46% yêu thích nhất, 41,4% muốn dùng tiếp) và là công cụ duy nhất có điểm CSAT/NPS công khai (91%/54).
- Cursor. Đứng thứ hai về "yêu thích nhất" với 19%, nhưng chỉ 11,7% muốn dùng tiếp, mức giảm lớn nhất từ thiện cảm sang ý định trong nhóm dẫn đầu.
- GitHub Copilot. Đứng thứ ba về "yêu thích nhất" với 9% nhưng thứ hai về ý định tương lai với 19,6%, phù hợp với lượng người dùng doanh nghiệp lớn.
- OpenAI Codex. Khoảng 8% chọn là công cụ yêu thích nhất, và 17,6% muốn dùng tiếp. Con số này sát Copilot ở cả hai chỉ số, và đứng thứ ba về ý định tương lai.
- OpenCode. Khoảng 7% chọn là công cụ yêu thích nhất, và 11,7% muốn dùng tiếp. Đây là lựa chọn mã nguồn mở được yêu thích.
Ở tầng model, khảo sát công nghệ 2026 của Stack Overflow cho thấy Anthropic và OpenAI ngang nhau về mức dùng (75% vs 74%), còn 49% muốn làm việc với Anthropic năm tới so với 32% chọn OpenAI.
Góc 3: Coding agent nào đạt điểm benchmark cao nhất?
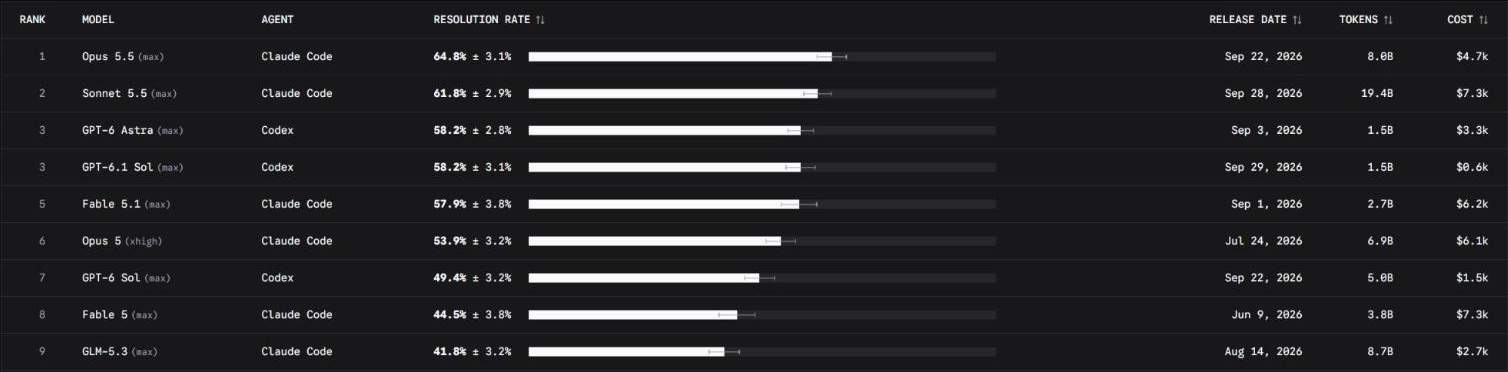
Terminal-Bench 4.0, phát hành ngày 28/8/2026, kiểm tra agent trong container terminal thực tế với 66 task và timeout 8 giờ. SWE-Bench Pro V2, phát hành ngày 22/9/2026, đánh giá các task dài hơi nhiều file trên 642 task thuộc 11 repo và chấm lại mọi diff trên image sạch. SWE Atlas v1.1, cập nhật tháng 11/2026, đo hiểu codebase, viết test và refactor trên 284 task.
| Hạng | Agent harness | Model (effort) | Tỷ lệ giải quyết task (95% CI) | Token | Chi phí chạy |
|---|---|---|---|---|---|
| 1 | Claude Code | Opus 5.5 (max) | 64,8% (±3,1%) | 8,0B | $4,7k |
| 2 | Claude Code | Sonnet 5.5 (max) | 61,8% (±2,9%) | 19,4B | $7,3k |
| 3 | Codex | GPT-6 Astra (max) | 58,2% (±2,8%) | 1,5B | $3,3k |
| 3 | Codex | GPT-6.1 Sol (max) | 58,2% (±3,1%) | 1,5B | $0,6k |
| 5 | Claude Code | Fable 5.1 (max) | 57,9% (±3,8%) | 2,7B | $6,2k |
Trên Terminal-Bench 4.0, Claude Code chạy Opus 5.5 cao hơn Codex chạy GPT-6.1 Sol 6,6 điểm phần trăm. Đợt chạy Codex chỉ tốn khoảng một phần tám chi phí ($0,6k so với $4,7k). Bài so sánh Codex và Claude Code phân tích kỹ sự đánh đổi này. Ở bản Terminal-Bench 2.0 và 2.1 cũ hơn (2025 và đầu 2026), Codex CLI cùng các harness (NexAU-AHE, Capy) từng dẫn đầu. Các bản cập nhật đảo thứ hạng rất nhanh.
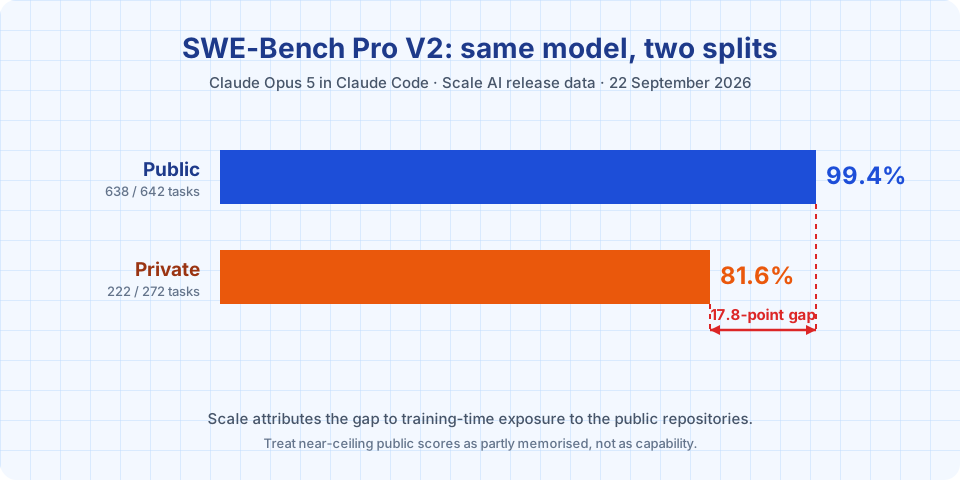
Trên SWE-Bench Pro V2, phần public gần chạm trần. Trong dữ liệu công bố của Scale, Claude Opus 5 giải được 638/642 task public (99,4%) nhưng chỉ 222/272 task private (81,6%). Đó là khoảng cách 17,8 điểm, mà Scale cho là do model đã thấy repo public trong lúc huấn luyện. Hãy coi điểm public sát trần là một phần ghi nhớ, không phải thước đo năng lực thuần.
Nghiên cứu harness của V2 kiểm tra cùng ý tưởng đó. Reflection chạy GLM-5.3, Kimi K3 và Inkling qua mini-swe-agent, Pi và OpenCode trên cùng 642 task. Độ chính xác gần như không đổi với Kimi K3 và GLM-5.3. Thứ thay đổi là token và thời gian mỗi task. Kết luận của Scale: "Pick the harness for the bill, not the score."
Bản thân benchmark cần được sửa. Cuộc audit tháng 7/2026 của OpenAI ước tính khoảng 30% bộ public cũ của SWE-Bench Pro bị lỗi và rút lại khuyến nghị dùng nó. V2 loại 89 task không hợp lệ và xác minh lại phần còn lại. Bảng SWE-bench Pro của BenchLM ngày 7/11/2026 ghi nhận các số model tự công bố: Claude Opus 5.5 đạt 89,9% và Sonnet 5.5 81,3%. Đây là claim cấp model, không phải một lần chạy harness chuẩn hóa.
Trên SWE Atlas v1.1, Opus 5.5 dẫn đầu với 77,4%, trên Fable 5.1 (74,1%), Gemini 4 Argon (70,1%), GPT-6 Astra (69,4%) và GPT-6.1 Sol (65,9%).
Top theo benchmark
- Claude Code. Công cụ này đứng nhất và nhì trên Terminal-Bench 4.0 với Opus 5.5 và Sonnet 5.5, và Claude Opus 5 dẫn đầu phần public của SWE-Bench Pro V2. Nó cũng tiêu thụ nhiều token nhất.
- Codex. Công cụ này đứng thứ ba trên Terminal-Bench 4.0 với GPT-6.1 Sol. Nó đạt 90% tỷ lệ giải quyết task của Claude Code với khoảng 13% chi phí chạy. GPT-6 Astra đứng thứ tư trên SWE Atlas v1.1 (69,4%).
- Các harness chuyên biệt. Trong nghiên cứu harness của V2, vòng lặp thay đổi chi phí và thời gian nhiều hơn độ chính xác với Kimi K3 và GLM-5.3. Hãy chọn harness theo hóa đơn. Với một harness mà cả vòng lặp cũng là plugin, xem bài đánh giá DeepSeek Harness qua dùng thử thực tế.
Bảng so sánh trực tiếp
| Agent | Cộng đồng | Đánh giá | Terminal-Bench 4.0 | Giá khởi điểm |
|---|---|---|---|---|
| Claude Code | 39% đi làm (#1); 65,5% SO chọn | CSAT 91%, NPS 54 (#1); 46% yêu thích | 64,8% (Opus 5.5, #1) | $20/tháng (Claude Pro) |
| Codex | 16% đi làm; 29,5% SO; 5M+ WAU; 95,6M npm/tháng | ≈8% yêu thích; 17,6% muốn dùng | 58,2% (GPT-6.1 Sol, #3) | $20/tháng (ChatGPT Plus) |
| Cursor | 12% đi làm; 25,5% SO; $4B+ ARR | Yêu thích #2 (19%); 11,7% muốn dùng | Tùy model | $8/tháng Plus, $30/tháng Premium (Cursor) |
| GitHub Copilot | 21% đi làm; 58,7% SO; 79% độ nhận biết | Yêu thích #3 (9%); 19,6% muốn dùng | Tùy model | Free; $10/tháng Pro (GitHub) |
| OpenCode | 7% đi làm; 225,2K sao (#1 OSS) | ≈7% yêu thích; 11,7% muốn dùng | Tùy model | CLI MIT miễn phí; token API |
Yêu thích = tỷ lệ chọn là công cụ yêu thích nhất (The Pragmatic Engineer, tháng 1 đến tháng 2/2026). Muốn dùng = tỷ lệ muốn dùng trong sáu tháng tới (Stack Overflow, tháng 6 đến tháng 8/2026).
Xếp hạng tổng thể và những điểm hạn chế của dữ liệu
Sau khi ưu tiên đánh giá của lập trình viên và kết quả benchmark hơn lượng cài đặt, thứ tự là Claude Code, Codex, Cursor, GitHub Copilot, OpenCode. Tỷ lệ dùng phản ánh quyết định mua sắm và thói quen. Điểm hài lòng và benchmark container cho thấy công cụ nào xử lý tốt ticket nhiều file hiện nay.
Dù vậy, bảng xếp hạng này có những khoảng mù rõ rệt. Góc cộng đồng trộn hai câu hỏi khác nhau. Một là tỷ lệ dùng tại nơi làm việc trên toàn bộ lập trình viên chuyên nghiệp (JetBrains); hai là lựa chọn công cụ trong nhóm đã dùng agent (Stack Overflow). Các con số không so trực tiếp được. Đợt khảo sát JetBrains tháng 5 đến tháng 7/2026 là mẫu đại diện mới nhất, nhưng thị trường đổi theo quý: đà giảm của Cursor và đà tăng của Codex có thể đảo chiều. Số liệu hài lòng nghiêng về nhóm chủ động chọn công cụ terminal, vốn thường chấm điểm hào phóng. Điểm benchmark cũng phản ánh cả trọng số model lẫn cấu hình max effort đốt nhiều token hơn hẳn thiết lập mặc định hằng ngày. Riêng Scale hiện công bố SWE-Bench Pro V2, SWE Atlas, MCP Atlas, HiL-Bench, RLI và DrugDiscoveryBench. Mỗi bảng đo một lát cắt khác nhau của công việc agent, và không bảng nào đủ để quyết định mua.
Không bảng xếp hạng nào chứng minh agent giúp nhóm bạn làm nhanh hơn. Trong thử nghiệm ngẫu nhiên tháng 7/2025 của METR, 16 lập trình viên mã nguồn mở giàu kinh nghiệm mất thêm 19% thời gian hoàn thành task khi dùng AI, dù tự cảm nhận nhanh hơn 20%. Nghiên cứu nối tiếp tháng 2/2026 của METR gặp sai lệch chọn mẫu vì lập trình viên từ chối làm việc trong nhóm không dùng AI. Hãy kết hợp agent với công cụ phát triển theo đặc tả (spec-driven development) và chạy thử hai tuần trên mười ticket thật của repo bạn trước khi chốt công cụ.
Câu hỏi thường gặp
AI coding agent nào tốt nhất năm 2026? Claude Code dẫn đầu tỷ lệ dùng tại nơi làm việc (39%), độ hài lòng (CSAT 91%) và tỷ lệ giải quyết task trên Terminal-Bench 4.0 (64,8%), và Claude Opus 5 dẫn đầu phần public của SWE-Bench Pro V2. Codex là lựa chọn tiết kiệm chi phí mạnh nhất trên benchmark ($0,6k so với $4,7k chi phí chạy), còn GitHub Copilot vẫn là mặc định ở doanh nghiệp (21% tỷ lệ dùng, 79% độ nhận biết).
Claude Code có tốt hơn Codex không? Trên Terminal-Bench 4.0, Claude Code chạy Opus 5.5 đạt mức cao hơn 6,6 điểm phần trăm so với Codex chạy GPT-6.1 Sol (64,8% so với 58,2%), còn Codex tốn chi phí chạy bằng khoảng một phần tám và có CLI mã nguồn mở Apache 2.0.
Có AI coding agent nào miễn phí không? OpenCode, Codex CLI, Cline, Gemini CLI và Aider là công cụ mã nguồn mở miễn phí, bạn chỉ trả tiền gọi API model hoặc nối model cục bộ. GitHub Copilot và Cursor cũng có gói miễn phí giới hạn lượt dùng.
AI coding agent có giúp lập trình viên làm việc nhanh hơn không? Khảo sát tự báo cáo cho kết quả tích cực, nhưng thử nghiệm có kiểm soát vẫn trái chiều. Thử nghiệm năm 2025 của METR ghi nhận lập trình viên giàu kinh nghiệm làm chậm hơn 19% khi dùng AI, còn đợt cập nhật năm 2026 không thể đo lại khoảng cách này vì lập trình viên từ chối làm việc nếu thiếu AI.
Tài Liệu Tham Khảo
- Bảng xếp hạng Terminal-Bench 4.0 và ghi chú phát hành (28/8/2026)
- Bảng xếp hạng SWE-Bench Pro V2 của Scale AI và bài công bố (22/9/2026)
- Scale AI SWE Atlas v1.1 (11/2026)
- JetBrains Research: AI Coding Tools at Work (4/2026) và AI Coding Agents: Adoption Trends (8/2026)
- Stack Overflow Developer Survey 2026 (6/10/2026), AI Data và Phương pháp
- The Pragmatic Engineer: AI Tooling 2026 (3/3/2026)
- Thông báo Series G của Anthropic và Claude Pricing
- OpenAI: Codex for Knowledge Work, API Pricing và audit đánh giá tháng 7/2026
- GitHub: sst/opencode, openai/codex, anthropics/claude-code, google-gemini/gemini-cli, cline/cline, Aider-AI/aider
- TechCrunch: Cursor $2B ARR, Dealroom: Cursor $4B ARR, Cursor Pricing và Copilot Plans
- METR: 2025 AI Developer Study và 2026 Uplift Update
- BenchLM: SWE-bench Pro (7/11/2026)